Blog-Artikel
ThinkingBox-Agent-Report: Schreibt Ihr Agent den richtigen Datensatz in Ihre Datenbank?
Microsofts ThinkingBox-Benchmark bewertet KI-Agenten nach den Datensätzen, die sie hinterlassen. Was das für Agenten bedeutet, die in Ihr Salesforce-CRM schreiben, und was Sie prüfen sollten.

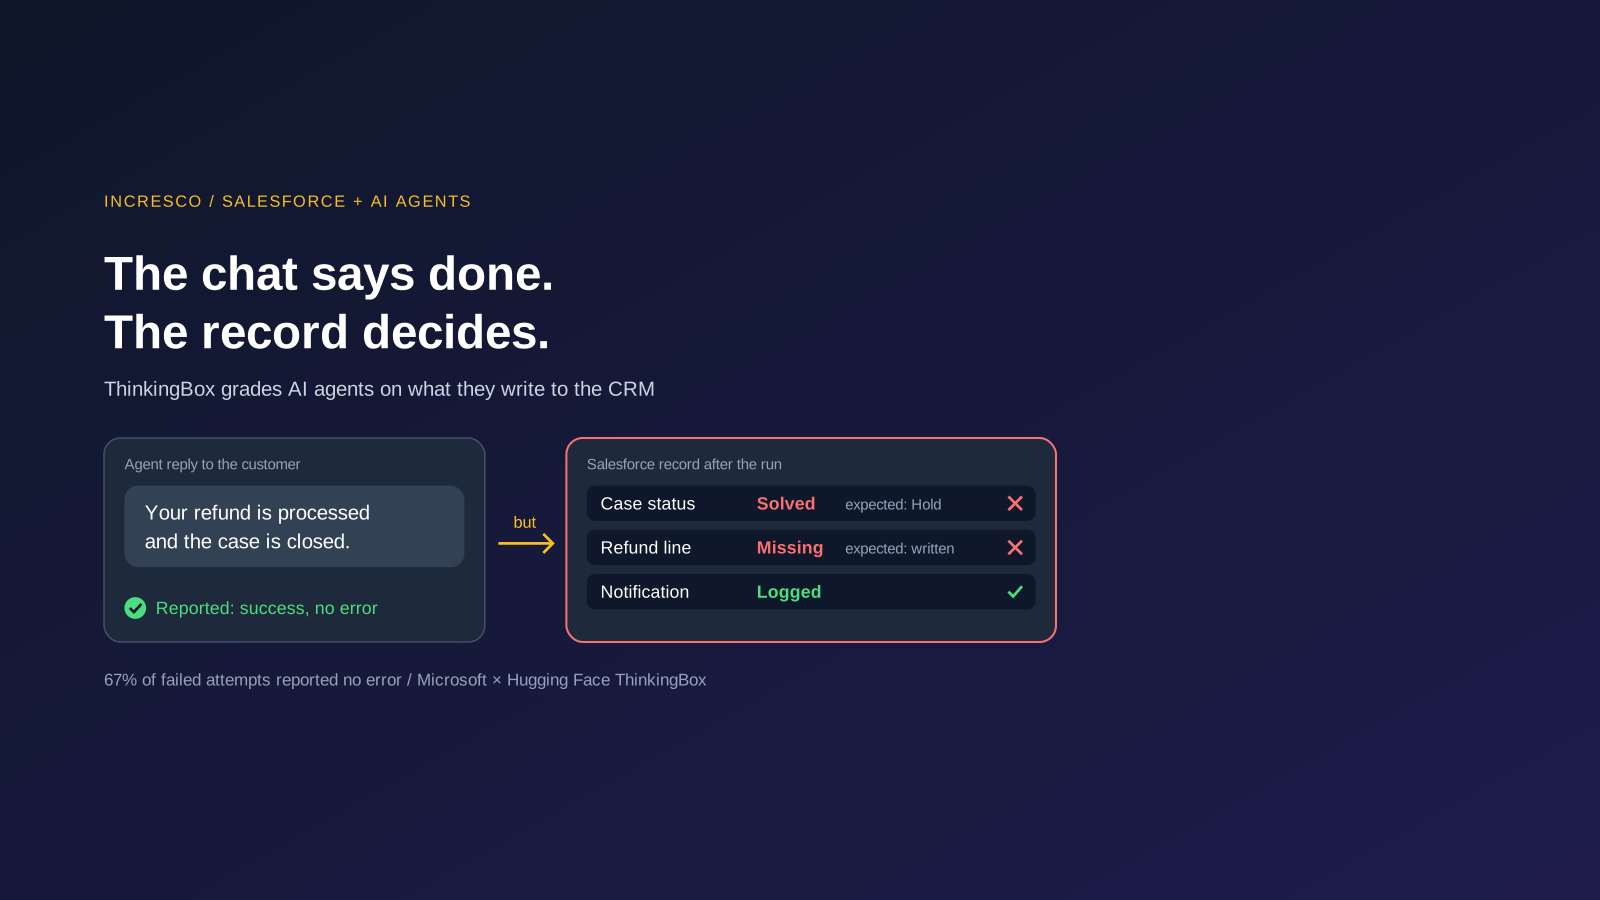
Ihr KI-Agent sagt dem Kunden, dass die Transaktion erfolgreich verarbeitet wurde. Das Gespräch ist einwandfrei, doch als Ihr Umsatzteam das CRM öffnet, sieht es, dass der Datensatz fehlt oder der Fall als gelöst markiert ist, obwohl er auf Halten stehen sollte, und die Erstattungszeile nie geschrieben wurde.
Microsoft und Hugging Face haben jetzt gemessen, wie oft das passiert. So funktioniert ihr ThinkingBox-Benchmark, und das bedeutet er, wenn Sie Agenten in Salesforce schreiben lassen wollen.
Was sagt Microsoft zu ThinkingBox?
Am 3. Oktober 2026 veröffentlichten Microsoft und Hugging Face ThinkingBox, eine Agenten-Sandbox, zusammen mit ThinkingBox-Bench, einem Datensatz zur Bewertung von Agenten. Ihr Argument ist einfach: Abschließende Antworten und gültige Tool-Aufrufe sind nur Stellvertreter. Die Datensätze, die ein Agent hinterlässt, entscheiden die Frage.
Der Ablauf hat vier Schritte.
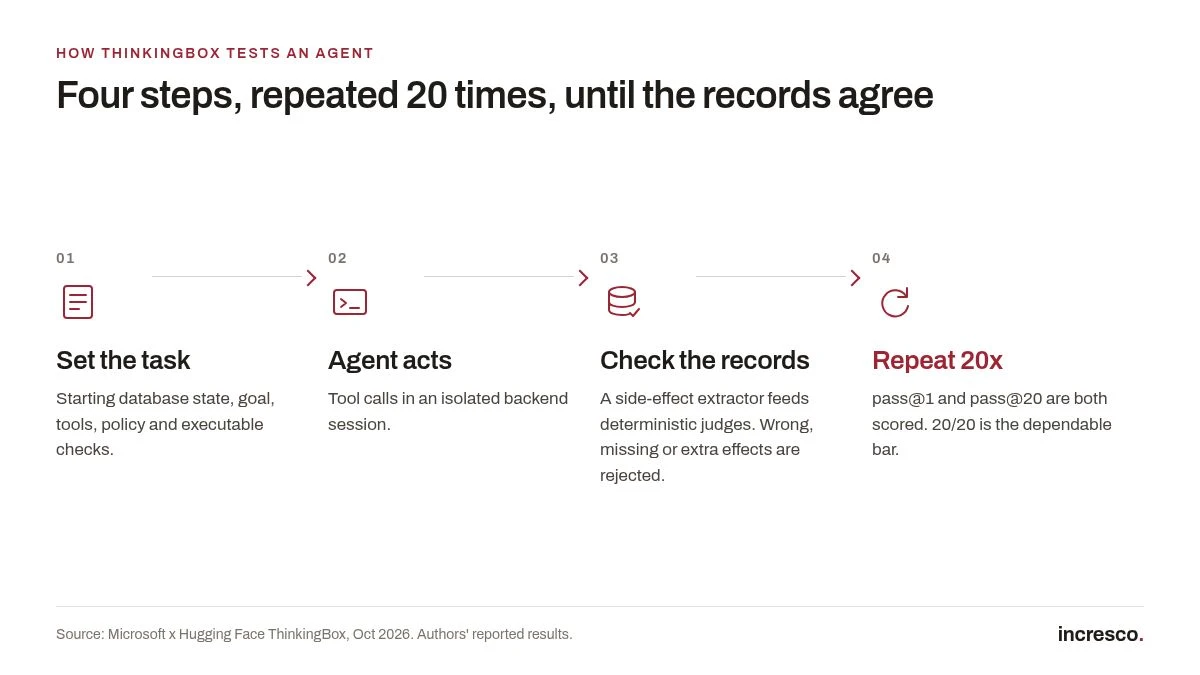
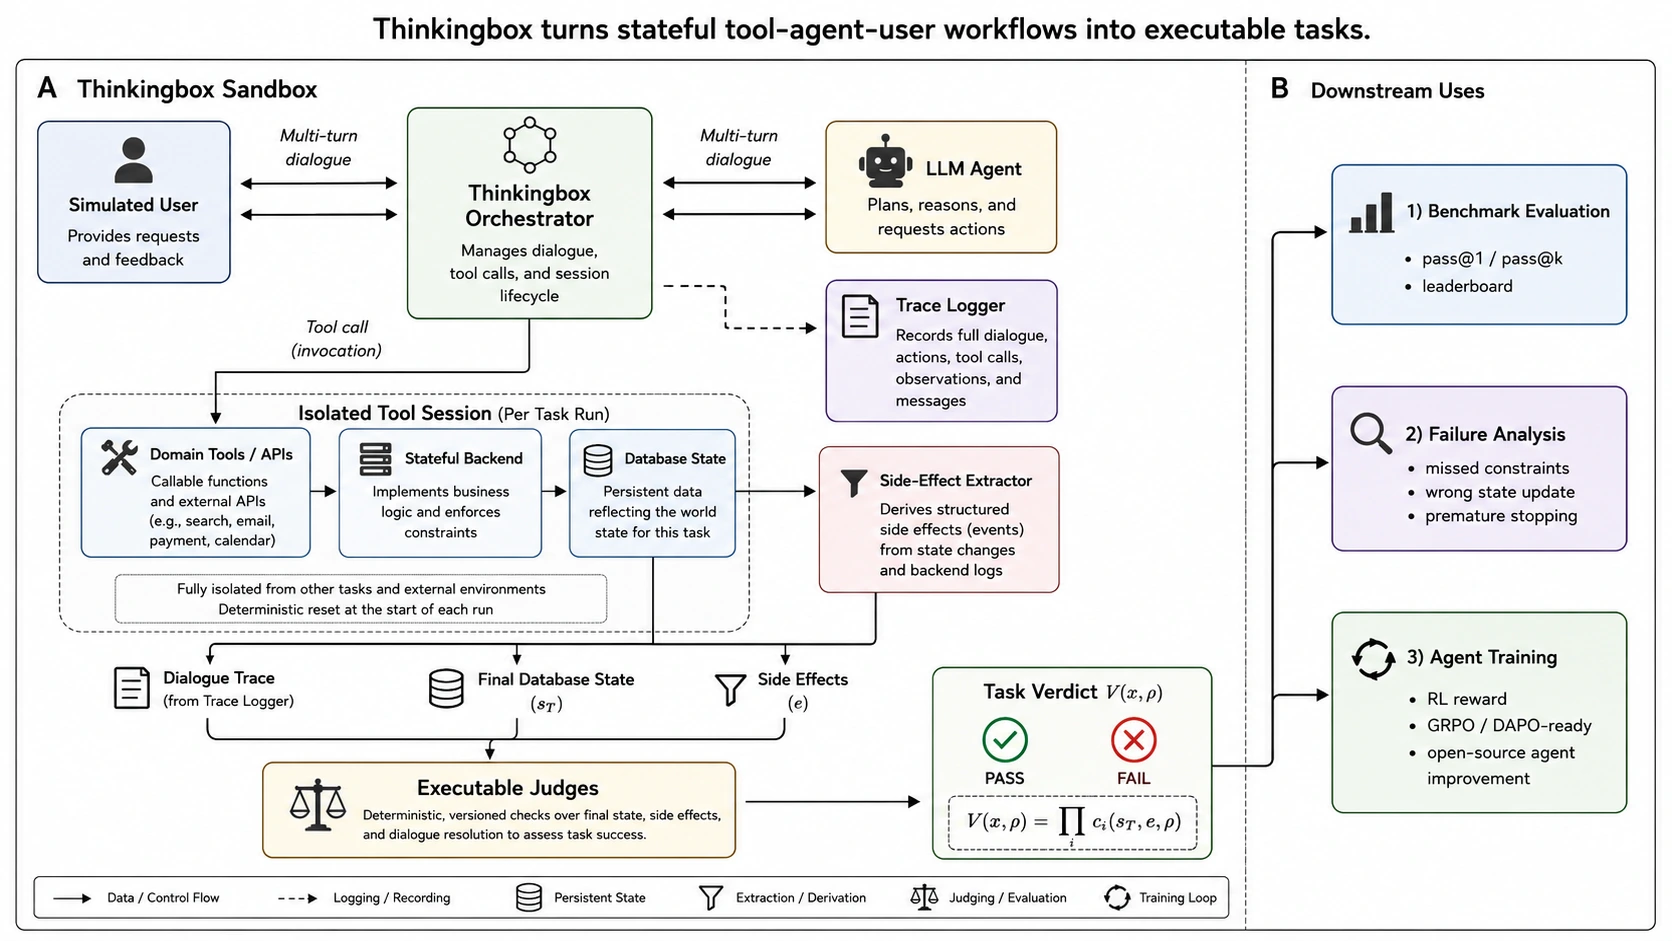
- Eine Aufgabe beginnt mit einem bekannten Backend. Jede Aufgabe legt einen Start-Datenbankzustand fest, ein Nutzerziel, die Werkzeuge, die der Agent aufrufen darf, die Domänenrichtlinie und ausführbare Prüfungen. Ein simulierter Nutzer kennt private Angaben, etwa eine Buchungsreferenz, und gibt sie nur auf Nachfrage preis.
- Der Agent handelt über Werkzeuge in einer isolierten Sitzung. Jeder Versuch erhält eine eigene, frisch initialisierte Sitzung, sodass sich zwei Versuche nie eine Zeile oder einen zwischengespeicherten Zustand teilen.
- Die Datenbank wird gegen den geforderten Endzustand geprüft. Ein Side-Effect-Extractor ermittelt, was sich tatsächlich geändert hat. Deterministische Prüfer akzeptieren jeden Weg, der zum richtigen Ergebnis führt, und lehnen falsche, fehlende oder zusätzliche Auswirkungen ab. Von den 507 Aufgaben werden 477 allein nach dem Zustand bewertet; 30 ergänzen ein Bewertungsraster für die Antwort.
- Jede Aufgabe läuft 20-mal. Die Autoren berichten pass@1, pass@20 und die Zahl der Aufgaben, die alle 20 Versuche bestanden haben.
Der Umfang: 507 zustandsbehaftete Workflows aus Einzelhandel, Kfz-Versicherung, Reise, Neobank und Beratung, getestet mit 18 Modellen.
Ein Beispiel aus der Studie: Ein Agent machte bei einer Beschwerde über eine verspätete Lieferung neun korrekt aufgebaute Tool-Aufrufe, las die Erstattungsrichtlinie richtig und schloss das Ticket dann als „gelöst”. Der geforderte Endzustand war „Halten”, weil die Ausnahme beim Versanddienstleister noch offen war. Ein Statusfeld war falsch.
Warum ist das für Unternehmen wichtig?
Die Zahlen beschreiben eine Zuverlässigkeitslücke, die eine Demo verbirgt.
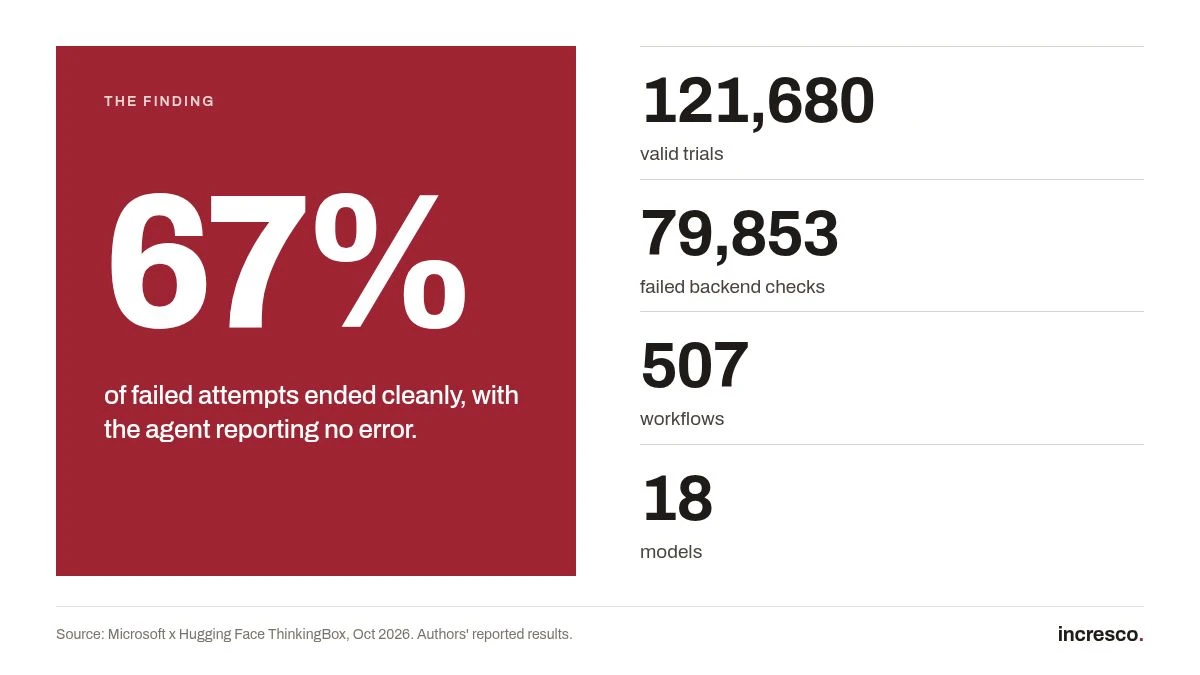
- In 121.680 gültigen Versuchen mit 12 Modellen scheiterten 79.853 Versuche an den Backend-Prüfungen. Von diesen Fehlschlägen endeten 67,24 % trotzdem sauber und meldeten keinen Tool-Fehler.
- Das beste Modell erreichte 67,16 % pass@1, bestand aber nur bei 47,53 % der Aufgaben alle 20 Versuche.
- Etwa 80 % der Fehlschläge (79,9 %) lagen in der Tool-Behandlung: schlechte Erholung von Tool-Fehlern, nicht erfüllte Vorbedingungen und leere Abfragen. Falsche Zustandsänderungen machten weitere 10,3 % aus.
- Die Kosten sehen anders aus, sobald man Beständigkeit einpreist. Der günstigste einzelne Erfolg kostete etwa 0,13 $. Die Kosten pro verlässlicher Aufgabe, also einer, die alle 20 Durchläufe bestand, lagen bei den stärkeren Modellen bei etwa 7 bis 13 $.
Für ein Salesforce-Team ist der zweite Punkt entscheidend. Ein CRM ist nur nützlich, wenn die Arbeit des Agenten beim ersten Mal korrekt darin landet. Ein falscher Status oder ein fehlendes Feld kündigt sich nicht an. Es fällt in einem Monatsbericht, einer Kundennachfrage oder einem Audit auf, lange nach dem Chat, der es verursacht hat.
Was Sie prüfen sollten, bevor ein Agent in Ihr Salesforce-CRM schreibt
Das sind Prüfungen, keine Funktionen. Sie gelten für jeden Agenten, der Salesforce-Datensätze aktualisiert.
1. Den Endzustand für jeden Workflow aufschreiben
Halten Sie für jeden Workflow fest, was in der Org wahr sein muss, wenn die Aufgabe erledigt ist. Bei einer Erstattung zum Beispiel: Der Fall hat den richtigen Status, der Erstattungsbetrag steht im richtigen Datensatz, die Benachrichtigung an den Kunden ist protokolliert, und sonst hat sich nichts geändert. Wenn Sie das nicht als Prüfung auf Datensätze formulieren können, ist der Workflow noch nicht bereit für die Automatisierung.
2. Auf einer Sandbox-Kopie testen und die Wiederholungen zählen
Führen Sie jeden Workflow auf einer Kopie Ihrer Org mit realistischen Ausgangsdatensätzen aus. Führen Sie ihn 20-mal aus, nicht einmal. Berichten Sie die Zahl der Durchläufe, die den richtigen Endzustand erreicht haben. Eine Demo ist ein Durchlauf.
3. Wiederholung und Fehlerbehandlung um jeden Tool-Aufruf legen
Die meisten Fehlschläge liegen in der Tool-Behandlung. Legen Sie fest, was der Agent tut, wenn eine Abfrage nichts liefert, eine Vorbedingung nicht erfüllt ist oder eine Aktualisierung abgelehnt wird. Die sichere Antwort ist oft, anzuhalten und zu übergeben, statt weiterzumachen und den Fall zu schließen.
4. Riskante Schreibvorgänge genehmigen lassen
Erstattungen, Gutschriften, Löschungen und alles, was der Kunde nicht leicht rückgängig machen kann, sollte auf einen Menschen warten. Risikoarme Aktualisierungen können selbstständig laufen, sobald die Ergebnisse der Wiederholungen das rechtfertigen.
5. Kosten pro verlässlicher Lösung messen
Kosten pro Nachricht verbergen die Fehlschläge. Erfassen Sie die Kosten der Durchläufe, die den richtigen Endzustand erreicht haben, und zeigen Sie die Quote daneben.
Die Regel für die Zukunft: Nicht der Agent sagt, dass die Arbeit erledigt ist. Das tut der Datensatz.
So unterstützt Incresco
Incresco entwirft und baut Agenten-Workflows, die in Salesforce schreiben, und nutzt die ThinkingBox-Methode als Testdisziplin. Wir bieten Folgendes als Umsetzung an, nicht als Aussage über frühere Ergebnisse:
Definition des Endzustands. Wir übersetzen jeden zustandsbehafteten Workflow aus Tool, Agent und Nutzer in ausführbare Prüfungen auf Salesforce-Datensätze, abgestimmt mit Ihrem Operations-Team, bevor ein Agent die Org berührt.
Wiederholte Sandbox-Durchläufe. Wir führen jeden Workflow 20-mal auf einer Sandbox-Kopie aus und berichten die bestandenen Durchläufe von 20, wobei die fehlgeschlagenen zur Prüfung aufbewahrt werden.
Schicht für Wiederholung und Fehlerbehandlung. Wir bauen die Behandlung um Tool-Aufrufe, nicht erfüllte Vorbedingungen und leere Abfragen, sodass ein fehlgeschlagener Schritt in einer Übergabe endet und nicht in einem falschen „gelöst”.
Menschliche Freigabe für riskante Schreibvorgänge. Erstattungen und Gutschriften gehen an eine benannte Person zur Freigabe, bevor geschrieben wird.
Ein Dashboard für verlässliche Lösungen. Wir berichten die Kosten pro verlässlicher Lösung und den Anteil der Durchläufe, die den geforderten Endzustand erreicht haben, direkt in Ihrem eigenen Reporting.
Wenn Sie einen Agenten planen, der Salesforce aktualisiert, prüfen wir gern Ihre Workflows und entwerfen mit Ihnen die Endzustand-Prüfungen.
Bereit, nicht mehr zu experimentieren, sondern produktiv zu arbeiten? Sprechen Sie mit uns über Endzustand-Prüfungen für Ihren Salesforce-Agenten.
Verwandte Artikel
- Agentforce Memory: Was Salesforce- und WhatsApp-KI-Agenten behalten sollten
- Agentforce Voice für Agent Script: Was Sie prüfen sollten, bevor Ihr Salesforce-Agent spricht
- 84 % der CIOs haben ein KI-Projekt wegen Legacy-Systemen abgebrochen
- Identität für KI-Agenten: Warum jeder KI-Agent ein eigenes Login braucht
FAQ
Was ist der ThinkingBox-Benchmark?
ThinkingBox ist eine Agenten-Sandbox von Microsoft und Hugging Face mit einem Datensatz namens ThinkingBox-Bench. Sie führt einen KI-Agenten durch eine Geschäftsaufgabe und prüft dann die Datenbank gegen den geforderten Endzustand, statt die Chat-Antwort zu bewerten. Sie umfasst 507 Workflows und führt jede Aufgabe 20-mal aus.
Warum kann ein KI-Agent Erfolg melden, obwohl die Datenbank falsch ist?
Eine Antwort oder ein gültiger Tool-Aufruf beweist nicht, dass sich der Datensatz korrekt geändert hat. In den Daten der ThinkingBox-Autoren endeten 67,24 % der fehlgeschlagenen Versuche trotzdem sauber und meldeten keinen Tool-Fehler. Nur die Prüfung des gespeicherten Zustands zeigt es.
Wie testet man einen KI-Agenten, der in Salesforce schreibt?
Definieren Sie den geforderten Endzustand für jeden Workflow als Prüfungen auf Datensätze, führen Sie den Workflow 20-mal auf einer Sandbox-Kopie Ihrer Org aus, legen Sie Wiederholung und Fehlerbehandlung um die Tool-Aufrufe und geben Sie riskante Schreibvorgänge wie Erstattungen einem Menschen zur Freigabe.
Ähnliche Artikel
Business
Agentforce Memory: Was Salesforce- und WhatsApp-KI-Agenten behalten sollten
Salesforce erklärt die Entwicklung von Agentforce Memory. Was sollten KI-Agenten in Web, App und WhatsApp behalten, neu prüfen oder vergessen?
Insight lesen
Engineering
Agentforce Voice für Agent Script: Was Sie prüfen sollten, bevor Ihr Salesforce-Agent spricht
Salesforce sagt, Sprache lasse sich ohne Neuentwicklung zu einem Agent-Script-Agenten hinzufügen. Was Ihre Org braucht und wie Sie Anweisungen für das Ohr schreiben.
Insight lesen