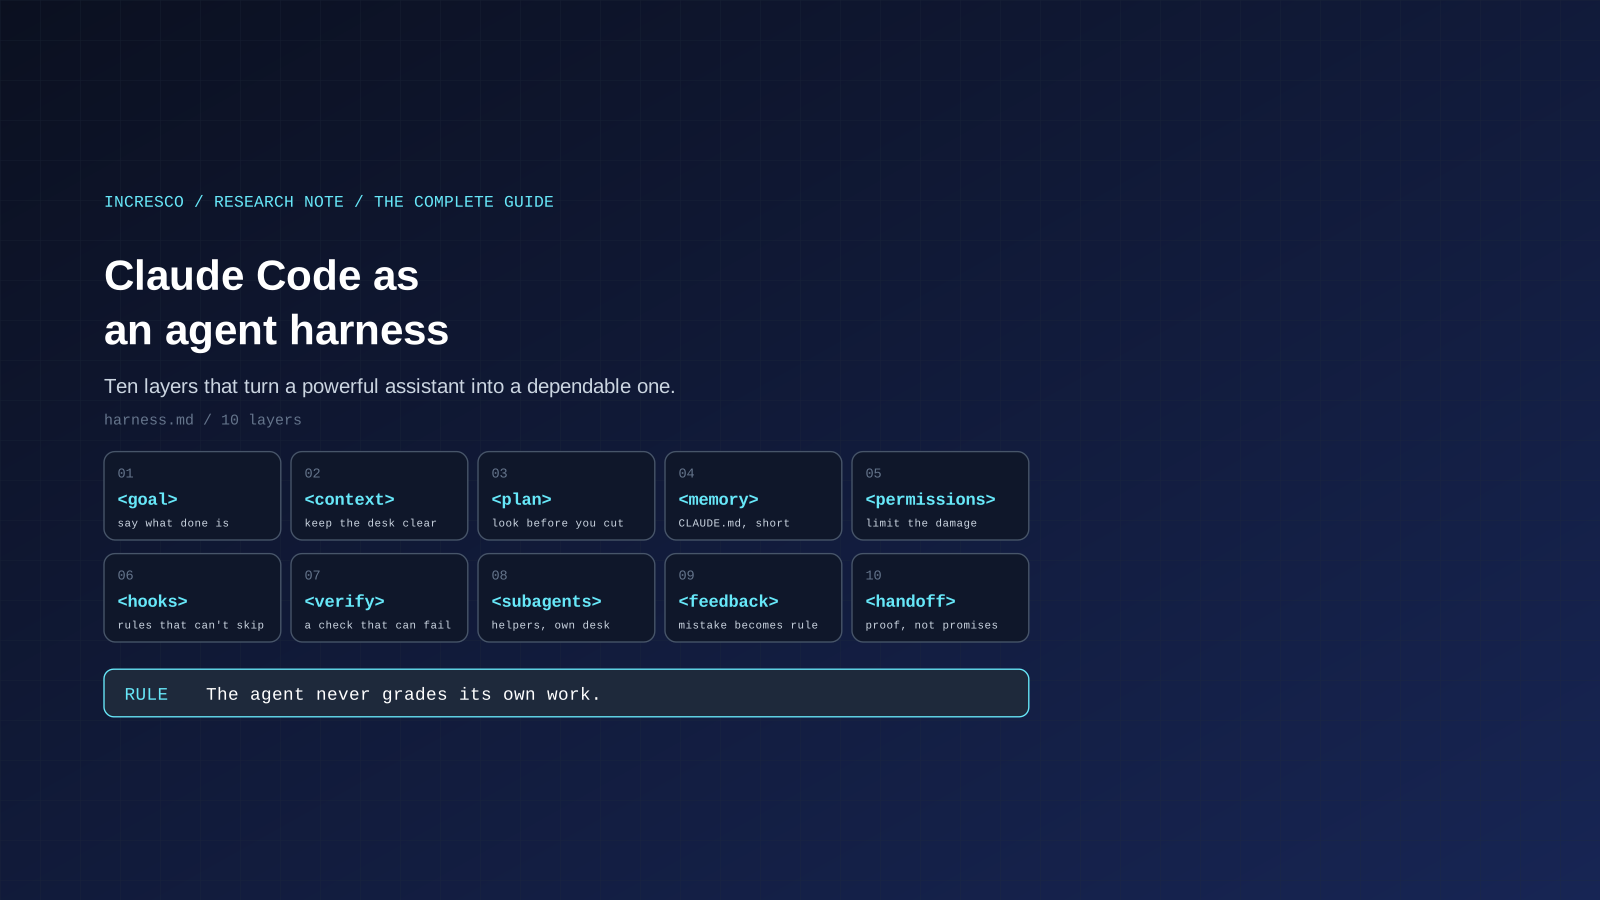
Blog-Artikel
Claude Code als Agent-Harness: Der vollständige Praxisleitfaden
Eine verständliche Praxisnotiz zu Claude Code als Agent-Harness: Ziel, Plan, Gedächtnis, Berechtigungen, Prüfung, Subagenten, Hooks, parallele Läufe und Übergabe. Jedes Verhalten an der Anthropic-Dokumentation geprüft.

Claude Code ist ein KI-Assistent von Anthropic, der direkt in Ihrem Softwareprojekt arbeitet. Er kann Dateien lesen, Befehle ausführen, Code ändern und die eigene Arbeit prüfen. Weil er selbstständig handelt, statt nur Fragen zu beantworten, nennt man solche Werkzeuge Agenten.
Auf einer Idee ruht dieser ganze Artikel. Einen starken Agenten macht nicht ein cleverer Prompt, sondern das Gerüst um ihn herum. Wir nennen dieses Gerüst Harness, so wie ein Pferdegeschirr oder ein Klettergurt das Zubehör ist, das etwas Kraftvolles sicher hält und in die richtige Richtung lenkt. Ein Harness beantwortet fünf einfache Fragen. Was weiß der Agent, bevor er anfängt? Was darf er anfassen? Woran erkennt er, dass die Arbeit fertig ist? Wer prüft das Ergebnis? Und was passiert mit der Lehre, wenn er etwas falsch macht?
Dies ist ein langer Leitfaden. Sie müssen Claude Code nicht schon kennen. Jeder Fachbegriff wird beim ersten Auftreten erklärt, und kurz vor dem Ende gibt es ein kleines Glossar. Struktur und Formulierungen stammen von uns. Inspiriert hat uns, was Boris Cherny, Schöpfer von Claude Code, öffentlich über seine Arbeit mit dem Werkzeug geschrieben hat. Jedes Produktverhalten unten haben wir an der Claude-Code-Dokumentation von Anthropic geprüft, die am Ende verlinkt ist. Wo etwas unsere eigene Praxis ist und kein dokumentiertes Verhalten, sagen wir es.
Ein Beispiel, das wir wiederverwenden
Stellen Sie sich eine kleine Web-App vor, und Sie bitten den Agenten: “Füge ein Zurücksetzen des Passworts per E-Mail hinzu.” Das klingt einfach. Es berührt aber den Login-Code, den E-Mail-Versand, die Datenbank und die Tests. Es ist ein gutes Beispiel, weil man es auf viele Arten subtil falsch machen kann. In jedem Abschnitt kommen wir darauf zurück.
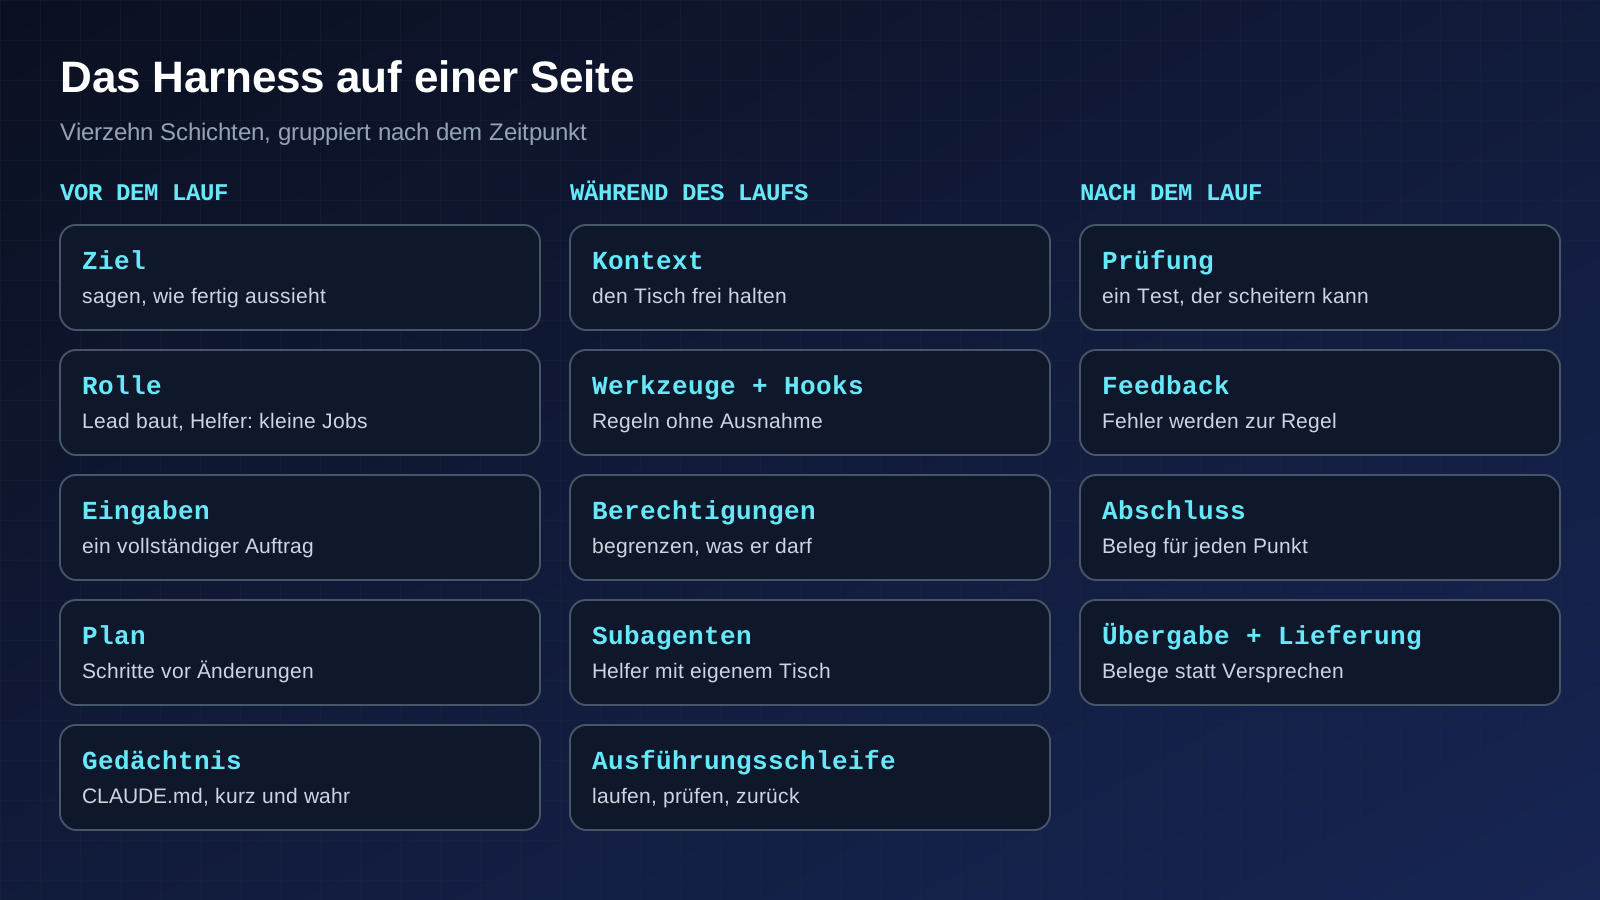
Das Harness auf einer Seite
| Schicht | Ihre Aufgabe in einfachen Worten | Erzwingt das Werkzeug sie? |
|---|---|---|
| Ziel | Sagen, wie “fertig” aussieht | Nein, das liegt bei Ihnen |
| Rolle | Festlegen, wer führt und wer begrenzte Aufgaben erledigt | Nein |
| Prinzipien | Die wenigen Gewohnheiten, auf denen alles andere ruht | Nein |
| Eingaben | Einen vollständigen Auftrag übergeben | Nein |
| Plan | Vor jeder Änderung die Schritte abstimmen | Ja, im Plan-Modus |
| Kontext | Das Kurzzeitgedächtnis des Agenten aufgeräumt halten | Nein |
| Werkzeuge und Hooks | ”Immer” und “nie” automatisch machen | Ja, bei Hooks |
| Berechtigungen | Begrenzen, was er anfassen darf | Ja |
| Gedächtnis | Fakten geben, die er dem Code nicht entnehmen kann | Nein, es ist ein Rat |
| Prüfung | Einen Bestanden-oder-nicht-Test liefern | Ja, wenn Sie sie zum Tor machen |
| Subagenten | Nebenaufgaben an Helfer geben | Teilweise, über die Werkzeugliste |
| Ausführungsschleife | Ausführen, prüfen, Fehlschläge zurückgeben, wiederholen | Durch Ihr Skript oder Ihre Gewohnheit |
| Feedback | Einen Fehler in eine dauerhafte Regel verwandeln | Je nachdem, wo Sie sie ablegen |
| Abschluss, Übergabe, Lieferung | Mit Beleg und sauberer Spur enden | Durch menschliche Prüfung |
Der Rest dieses Leitfadens geht diese Tabelle von oben nach unten durch. Jeder Abschnitt endet mit den benannten Regeln, die wir nutzen, damit Sie sie übernehmen können.
1. Ziel: Sagen, wie “fertig” aussieht
Der Leitfaden von Anthropic sagt, dass Claude Ihre Absicht erraten, aber keine Gedanken lesen kann, und dass präzise Anweisungen weniger Korrekturen bedeuten. Seine Beispiele folgen einem Muster: den Umfang benennen, auf ein Beispiel zeigen und das Symptom beschreiben.
- Umfang heißt: welche Datei, welche Situation. “Füge Tests für foo.py hinzu” ist vage. “Schreibe einen Test für foo.py, der den Fall eines abgemeldeten Nutzers abdeckt, und verwende keine Mocks” ist konkret. (Ein Mock ist ein Platzhalter, der einen echten Teil des Systems vortäuscht. Tests, die nur Attrappen nutzen, können bestehen, während das echte System kaputt ist.)
- Beispiel heißt: auf etwas Vorhandenes zeigen. “Sieh dir an, wie die bestehenden Widgets auf der Startseite gebaut sind, und folge diesem Muster.”
- Symptom heißt: sagen, was Sie beobachten, wo Sie die Ursache vermuten und wie “behoben” aussieht. “Nutzer berichten, dass der Login nach Ablauf der Sitzung fehlschlägt. Prüfe den Code zur Token-Erneuerung und schreibe zuerst einen fehlschlagenden Test, der das nachstellt.”
Unsere Ergänzung: Schreiben Sie das Ziel als Satz, der mit einer Prüfung endet. Für das Passwort-Zurücksetzen: “Fertig, wenn ein neuer Test belegt, dass die Zurücksetzen-E-Mail verschickt wird und der Link nur einmal funktioniert, und die Prüfungen des Projekts bestehen.”
Für größere Funktionen beschreibt der Leitfaden einen Interview-Schritt. Sie bitten Claude, Sie zu Sonderfällen und Abwägungen zu befragen, und das Ergebnis in eine Spezifikationsdatei zu schreiben. Eine Spezifikation ist einfach eine schriftliche Beschreibung dessen, was gebaut werden soll. Danach starten Sie eine frische Sitzung, um sie umzusetzen. Die neue Sitzung beginnt sauber und fokussiert, und Sie haben ein Dokument zum Nachschlagen. Der Leitfaden ergänzt, dass die besten Spezifikationen die betroffenen Dateien nennen, sagen, was nicht dazugehört, und mit einem Test enden, der die ganze Funktion belegt.
Vage Prompts haben weiterhin ihren Platz. Anthropic merkt an, dass sie beim Erkunden nützlich sind, wenn Sie unterwegs nachsteuern können.
2. Rolle: Wer führt, wer erledigt die kleinen Aufgaben
Ein Harness funktioniert besser, wenn jede Seite eine klare Aufgabe hat. Unsere ist einfach.
- Die führende Sitzung baut und pflegt das Harness. Sie liest zuerst die vorhandenen Anweisungen des Projekts und den aktuellen Stand der Arbeit, bevor sie etwas ändert. Sie schreibt den Plan, führt die Ergebnisse zusammen und entscheidet, was sich am Setup ändert.
- Subagenten erledigen begrenzte Arbeit. Jeder bekommt einen Schritt, seine Eingaben und seine Prüfung, nicht mehr (Abschnitt 11).
- Der Mensch besitzt das Ziel und die letzte Freigabe. Sie legen fest, was “fertig” heißt, und Sie geben den Schritt frei, der am schwersten rückgängig zu machen ist.
Daraus folgen zwei benannte Regeln. Erst lesen, dann ändern: Die führende Sitzung schaut zuerst auf die Anweisungen des Projekts und die vorhandene Arbeit. Entscheidungen festhalten, die das Harness verändern: Wird während eines Laufs eine neue Regel, ein Hook oder eine Berechtigung ergänzt, wird sie dort notiert, wo die nächste Sitzung sie findet.
Diese Aufteilung ist unsere Praxis. Die Dokumentation beschreibt die Bausteine, etwa Subagenten mit eigenem Kontext und eigenen Werkzeugen, und wir ordnen sie so an.
3. Prinzipien: Vier Gewohnheiten, auf denen alles ruht
Wenn Sie sich sonst nichts merken, merken Sie sich diese. Jede entspricht einem Rat aus Anthropics eigenem Best-Practices-Leitfaden, und sie decken sich mit dem, was Boris Cherny öffentlich über seine Arbeit mit Claude Code gesagt hat.
- Im Plan-Modus starten und den Plan abstimmen, bevor etwas geändert wird. Anthropic empfiehlt, Erkunden und Planen vom Programmieren zu trennen, damit Sie nicht das falsche Problem lösen.
- Dem Modell eine Möglichkeit geben, seine Arbeit selbst zu prüfen. Anthropic nennt das in seinem Leitfaden zuerst: Eine Prüfung, die der Agent ausführen kann, ist der Unterschied zwischen einer Sitzung, die Sie beobachten, und einer, die Sie allein lassen können.
- Passiert ein Fehler, die Regel dorthin legen, wo sie hält. Anthropic rät, CLAUDE.md wie Code zu behandeln, sie laufend zu verfeinern und Zeilen zu streichen, die ihren Platz nicht verdienen.
- Parallele Sitzungen nur für unabhängige Arbeit. Dokumentiert ist, jeder Sitzung eine eigene, isolierte Kopie des Projekts zu geben, damit sich Änderungen nicht überschneiden.
Der Rest des Leitfadens macht diese vier Gewohnheiten konkret.
4. Eingaben: Der Auftrag
Ein Agent ist nur so gut wie der Auftrag, den Sie ihm geben. Vor einem langen Lauf füllen wir sechs Felder aus. Das ist unsere Praxis, und es ist dieselbe Idee wie der Interview-Schritt, den Anthropic für größere Funktionen beschreibt.
| Feld | Was hineingehört | Beispiel für das Passwort-Zurücksetzen |
|---|---|---|
| Aufgabe | Ein Satz mit dem Ergebnis | Nutzer können ein vergessenes Passwort per E-Mail zurücksetzen |
| Ergebnis und Ablageort | Was Sie bekommen und wo es liegt | Ein Pull Request und ein kurzer Bericht |
| Abnahmeprüfungen | Die Befehle, die bestehen müssen | Die neuen Tests, der Build, Lint |
| Quellmaterial | Was er lesen oder verwenden darf | Der vorhandene Login- und E-Mail-Code, die Sicherheitsnotizen |
| Erlaubte Änderungen | Was er anfassen darf | Der Auth-Ordner und seine Tests, sonst nichts |
| Laufgrenze | Wann Schluss ist | Drei Versuche pro Schritt oder eine Stunde |
Füllen Sie das aus, bevor Sie starten. Würde eine fehlende Angabe das Ergebnis ändern, sollte der Agent eine gezielte Frage stellen, statt zu raten. Ein Rateversuch, den Sie nicht bemerken, kostet mehr als eine Frage, die Sie in zehn Sekunden beantworten.
5. Plan: Erst schauen, dann schneiden
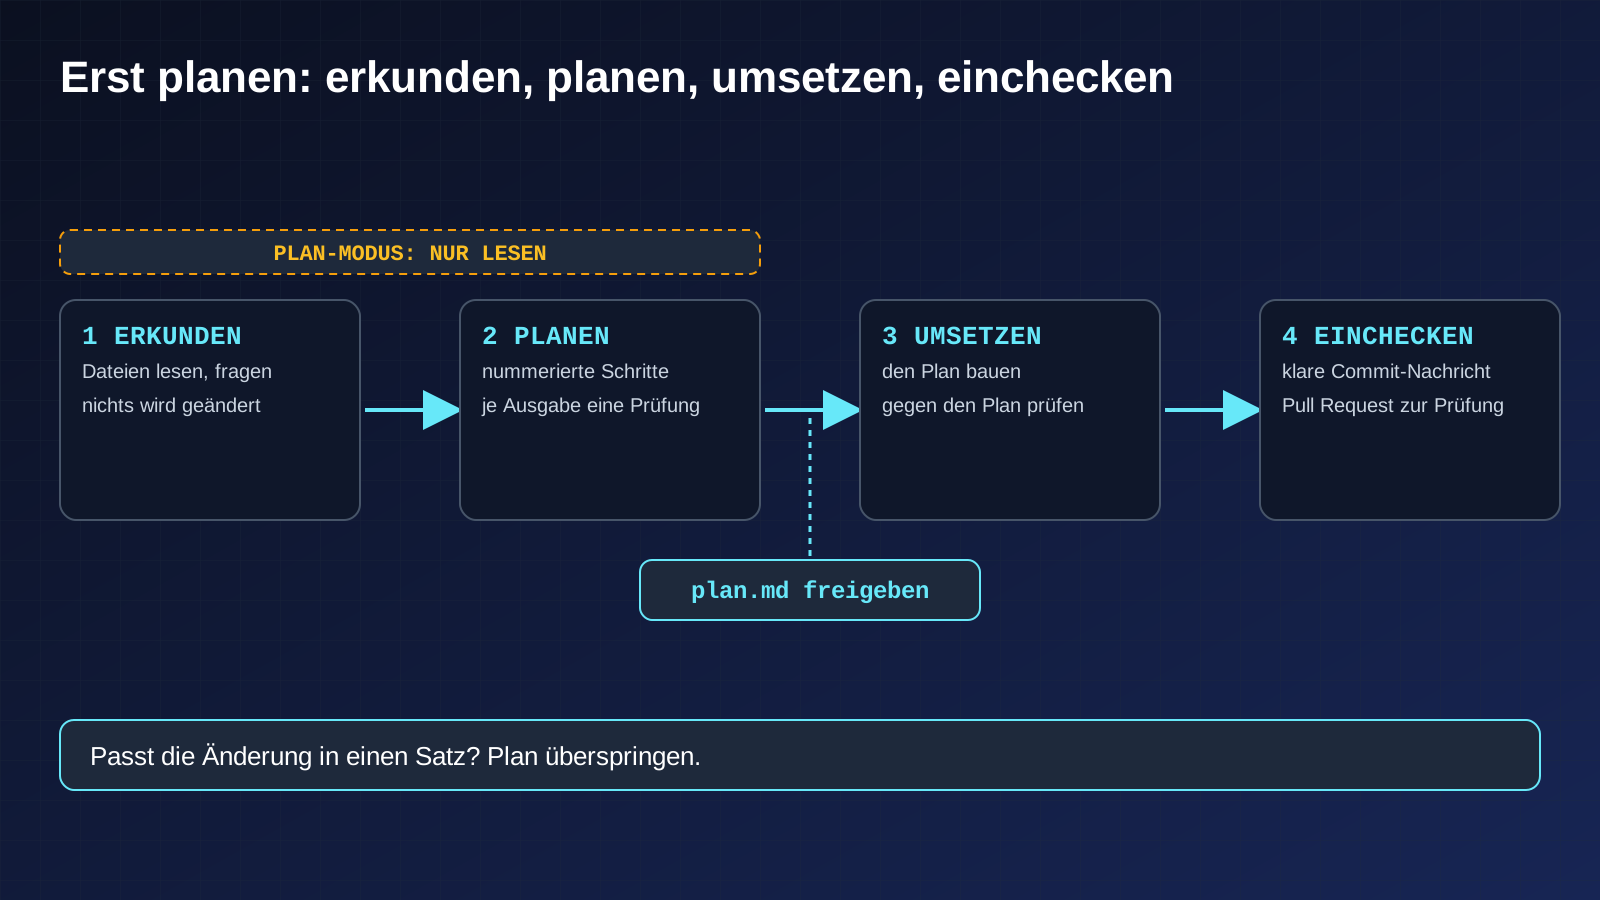
Anthropic empfiehlt vier Phasen: erkunden, planen, umsetzen, einchecken. Für die ersten beiden hat Claude Code einen Plan-Modus. Darin kann der Agent Dateien lesen und Fragen beantworten, aber nichts verändern. Sie schalten ihn ein, indem Sie Shift+Tab drücken, bis die Statusleiste ihn zeigt, oder mit claude --permission-mode plan starten.
Für das Passwort-Zurücksetzen sieht das so aus:
- Erkunden. “Lies, wie wir Sitzungen behandeln und wo Geheimnisse gespeichert sind.” Eine Frage, kein Befehl.
- Planen. “Welche Dateien müssen sich ändern, und wie ist der Ablauf? Erstelle einen Plan.” Laut Dokumentation öffnet
Ctrl+Gden Plan in Ihrem Texteditor, sodass Sie ihn bearbeiten können, bevor es losgeht. - Umsetzen. Plan genehmigen, dann bauen lassen, Tests schreiben, ausführen und Fehler beheben.
- Einchecken. Um eine klare Commit-Nachricht und einen Pull Request bitten. Ein Commit ist ein gespeicherter Stand von Änderungen. Ein Pull Request ist ein Vorschlag, diese Änderungen ins Hauptprojekt zu übernehmen, damit Menschen sie prüfen können.
Unsere Praxis: den Plan wie einen Vertrag behandeln. Einen falschen Schritt aus einem Plan zu streichen kostet eine Zeile. Ihn aus fertigem Code zu entfernen kostet ein ganzes Review.
Planen hat Kosten, und Anthropic sagt das. Bei einem Tippfehler, einer Logzeile oder einer Umbenennung bitten Sie einfach um die Änderung. Die Regel im Leitfaden ist leicht zu merken: Wenn Sie die Änderung in einem Satz beschreiben können, überspringen Sie den Plan.
Benannte Regeln für Pläne (unsere Praxis):
- Den Plan als nummerierte Schritte schreiben, jeder mit einer Ausgabe und einer Prüfung.
- Die Dateien nennen, die jeder Schritt liest und schreibt.
- Markieren, welche Schritte unabhängig sind und gleichzeitig laufen können.
- Die Prüfungen vor der Arbeit schreiben, nicht danach.
- Den Plan in einer Datei speichern (wir nennen sie
plan.md) und vor jeder Änderung auf Ihre Freigabe warten.
6. Kontext: Das Kurzzeitgedächtnis des Agenten
Hier ist die eine Grenze hinter den meisten Ratschlägen im Leitfaden von Anthropic: Das Kontextfenster von Claude füllt sich schnell, und die Leistung sinkt, je voller es wird. Das Kontextfenster ist alles, was der Agent während einer Sitzung im Kopf hält: Ihre Nachrichten, jede gelesene Datei, jede Befehlsausgabe. Denken Sie an einen Schreibtisch. Ein freier Tisch erlaubt gutes Arbeiten. Ein Tisch unter Papierbergen nicht.
Darum sind viele Gewohnheiten eigentlich Aufräumgewohnheiten:
- Zwischen unabhängigen Aufgaben zurücksetzen mit dem Befehl
/clear. Das Gegenteil nennt der Leitfaden die Alles-durcheinander-Sitzung: Sie fragen nach etwas, dann nach etwas ganz anderem, kehren zum ersten zurück, und der Tisch liegt voller unpassender Papiere. - Gezielt verdichten. Nähert sich das Fenster dem Limit, fasst Claude das Gespräch automatisch zusammen, um Platz zu schaffen. Sie können steuern, was bleibt, etwa “konzentriere dich auf die API-Änderungen”, oder in Ihrer Gedächtnisdatei festhalten, was immer erhalten bleiben muss, zum Beispiel die Liste geänderter Dateien und die Testbefehle.
- Nachsehen, was geladen ist. Der Befehl
/contextzeigt, was im Fenster liegt. - Kurze Nebenfragen günstig stellen mit
/btw, dessen Antwort nie in den Gesprächsverlauf gelangt. - Untersuchungen eingrenzen. Der Leitfaden nennt die “endlose Erkundung”: Wer “untersuche das” ohne Grenzen sagt, bei dem liest Claude womöglich Hunderte Dateien und füllt den Tisch. Stellen Sie eine enge Frage oder geben Sie die Aufgabe an einen Subagenten (Abschnitt 11).
Benannte Regeln für den Kontext (unsere Praxis):
- Nur laden, was der Schritt braucht: die Briefing-Datei plus die Dateien, die der Schritt nennt.
- Bei der Übergabe an einen Subagenten den Schritt, seine Eingaben und seine Prüfung weitergeben, nicht das ganze Gespräch.
- Lange Logs und rohe Befehlsausgaben aus der Hauptsitzung heraushalten. Zusammenfassungen als Pfade, Urteile und Belege anfordern.
- Die Hauptsitzung für Entscheidungen nutzen, nicht für die Suche.
7. Werkzeuge und Hooks: Regeln automatisch machen
Werkzeuge. Anthropic nennt Kommandozeilen-Werkzeuge den effizientesten Weg für den Agenten, mit externen Diensten zu arbeiten, weil sie wenig vom Tisch belegen. Ein Kommandozeilen-Werkzeug ist ein Programm, das man per Befehlseingabe startet, etwa gh für GitHub. Installieren Sie die, die Sie nutzen, und sagen Sie Claude, dass es sie verwenden soll. Für Dienste ohne gutes Kommandozeilen-Werkzeug verbinden MCP-Server etwa einen Issue-Tracker oder eine Datenbank. (MCP ist ein Standard, um externe Werkzeuge an einen KI-Agenten anzuschließen.) Claude kann ein unbekanntes Werkzeug sogar lernen, indem es dessen --help-Text liest.
Hooks. Ein Hook ist ein kleines Skript, das Claude Code automatisch zu einem festen Zeitpunkt ausführt, etwa kurz bevor der Agent eine Datei ändert oder kurz nachdem er fertig ist. Anthropic beschreibt den Punkt genau: Hooks geben Ihnen deterministische Kontrolle, sodass manche Dinge immer passieren, statt sich darauf zu verlassen, dass das Modell daran denkt. Deterministisch heißt nur: Jedes Mal passiert dasselbe.
Unsere Faustregel: Wenn es Sie auch nur einmal ärgern würde, dass es übersprungen wurde, ist es keine Anweisung. Es ist ein Hook. Formatieren, Linting, Typprüfungen und das Sperren von Schreibzugriffen auf einen geschützten Ordner gehören hierher. Ein Prompt ist nur für Urteilsfragen da.
| Ereignis | Wann es auslöst | Typischer Einsatz |
|---|---|---|
PreToolUse | Bevor der Agent ein Werkzeug nutzt; kann blockieren | Änderungen in einem geschützten Ordner stoppen, einen gefährlichen Befehl verweigern |
PostToolUse | Nachdem ein Werkzeug erfolgreich war | Nach jeder Änderung automatisch formatieren oder linten |
Stop | Wenn Claude fertig geantwortet hat | Ihre Prüfungen ausführen und das Ende verweigern, bis sie bestehen |
SubagentStop | Wenn ein Helfer fertig ist | Die Ausgabe des Helfers prüfen |
PreCompact, PostCompact | Rund um das Zusammenfassen | Sichern oder wiederherstellen, was erhalten bleiben muss |
SessionStart | Wenn eine Sitzung beginnt oder fortgesetzt wird | Kontext laden |
Wissenswertes zur Funktionsweise, alles aus dem Hooks-Leitfaden:
- Ein Hook erhält Details zum Ereignis als JSON (ein einfaches strukturiertes Textformat) und antwortet über seinen Exit-Code und seine Ausgabe. Ein Exit-Code ist die Zahl, die ein Programm beim Beenden zurückgibt. Null bedeutet meist: in Ordnung.
- Exit-Code 2 blockiert die Aktion, aber nur davor. Bei
PreToolUseblockiert er den Werkzeugaufruf, und der Grund, den Sie in die Fehlerausgabe schreiben, geht an Claude zurück, damit es sich anpassen kann. BeiPostToolUseist das Werkzeug schon gelaufen, Exit-Code 2 kann es also nicht rückgängig machen. Claude sieht nur Ihre Nachricht. - Exit-Code 0 bei einem
PreToolUse-Hook genehmigt die Aktion nicht. Der normale Berechtigungsablauf gilt weiter. - Passen mehrere Hooks, laufen alle. Dass ein Hook nein sagt, hebt nicht auf, was ein anderer Hook tut. Verlassen Sie sich darauf nicht.
- Matcher schränken den Bereich ein.
Edit|Writepasst auf Werkzeuge, die Dateien ändern.Bashpasst auf Shell-Befehle. - Dateien können sich auch durch Shell-Befehle ändern. Muss ein Hook jede Änderung sehen, schlägt die Dokumentation einen
Stop-Hook vor, der das Projekt einmal pro Zug scannt. Stop-Hooks haben eine Obergrenze von 8 aufeinanderfolgenden Blockaden. Hat ein Stop-Hook den Zug achtmal hintereinander weitergeführt, beendet Claude Code ihn trotzdem, damit ein festgefahrener Agent nicht endlos kreist. Der Zähler setzt sich zurück, sobald Claude ein Werkzeug aufruft.
Claude kann Hooks für Sie schreiben. Die Beispiele des Leitfadens sind “führe nach jeder Dateiänderung eslint aus” und “blockiere Schreibzugriffe auf den Migrationsordner”. Lesen Sie, was es schreibt, denn ein Hook läuft mit Ihren Berechtigungen.
Benannte Regeln für Hooks (unsere Praxis):
- Jeden Hook und jedes Skript in der Briefing-Datei auflisten, damit die nächste Sitzung weiß, was automatisch läuft.
- Sich bei einer deterministischen Regel nie darauf verlassen, dass das Modell daran denkt.
- Fehlt ein nötiges Werkzeug, das Hindernis benennen und die Schritte weiterführen, die noch machbar sind, statt die Regel stillschweigend zu überspringen.
8. Berechtigungen: Was er ohne Nachfrage tun darf
Hooks und Werkzeuge bestimmen, was passiert. Berechtigungen bestimmen, was der Agent von sich aus tun darf. In der vorsichtigen Voreinstellung fragt Claude, bevor es Dateien schreibt oder Befehle ausführt. Das ist sicher, aber ermüdend. Die deutliche Beobachtung des Leitfadens: Nach der zehnten Freigabe klicken Sie nur noch durch, statt zu prüfen. Zwei dokumentierte Hilfsmittel helfen:
- Erlaubnislisten geben bestimmte sichere Aktionen vorab frei, etwa
npm run lintodergit commit. Verwalten Sie sie mit/permissions. - Sandboxing isoliert über das Betriebssystem, auf welche Dateien und welches Netzwerk der Agent zugreifen kann, sodass er innerhalb eines abgesteckten Bereichs frei arbeiten kann.
Anthropic beschreibt außerdem einen Auto-Modus, in dem ein separates Prüfmodell Aktionen kontrolliert und riskante blockiert, zum Beispiel wenn sie über die Aufgabe hinausgehen, unbekannte Systeme berühren oder auf Anweisungen in nicht vertrauenswürdigen Inhalten reagieren. In welchem Modus Sie starten, hängt von Version und Tarif ab, schauen Sie also in die Dokumentation.
Prüfen Sie die aktiven Berechtigungen, bevor ein Lauf beginnt. Wo eine Regel durchgesetzt werden muss, konfigurieren Sie sie in den Werkzeugregeln oder in der Sandbox. Worte in einem Prompt sind keine Grenze.
Benannte Regeln für Berechtigungen (unsere Praxis):
- Vor dem Veröffentlichen, Senden oder Ausgeben fragen. Alles, was Ihren Rechner verlässt oder Geld kostet, braucht einen Menschen.
- Nie zwei Sitzungen dieselbe Datei bearbeiten lassen. Geben Sie jeder eine eigene Kopie des Projekts (einen Worktree, Abschnitt 13).
- Vor einer riskanten Änderung eine wiederherstellbare Version behalten, zum Beispiel einen Commit, damit Sie zurückgehen können. Claudes Checkpoints helfen, ersetzen aber, wie Anthropic anmerkt, git nicht.
- Die Strenge danach wählen, was ein Fehler kosten würde, nicht danach, wie sehr Sie dem Agenten heute vertrauen.
9. Gedächtnis: Die Briefing-Datei
Der Agent vergisst alles zwischen den Sitzungen. Eine Datei namens CLAUDE.md behebt das. Claude liest sie zu Beginn jeder Unterhaltung, wie eine Notiz für eine neue Kollegin am ersten Arbeitstag.
Die Memory-Dokumentation nennt, wo die Datei liegen kann. Sie werden vom Allgemeinsten zum Spezifischsten geladen:
| Geltungsbereich | Ort | Wer sie bekommt |
|---|---|---|
| Organisation | Ein von der IT des Unternehmens festgelegter Pfad | Alle in der Organisation |
| Sie | ~/.claude/CLAUDE.md | Nur Sie, in jedem Projekt |
| Projekt | ./CLAUDE.md oder ./.claude/CLAUDE.md | Das Team, über Git geteilt |
| Lokal | ./CLAUDE.local.md | Nur Sie, nur dieses Projekt |
(Git ist das übliche Werkzeug, um Änderungen am Code zu verfolgen und im Team zu teilen.)
Der wichtigste Satz dieser Dokumentation ist dieser: Claude behandelt CLAUDE.md als Kontext, nicht als erzwungene Konfiguration. Eine Zeile in der Datei ist eine Bitte, kein Schloss. Wenn etwas immer gelten muss, verweist die Dokumentation auf einen Hook, den wir in Abschnitt 7 behandeln.
Was hineingehört. Die Liste aus dem Leitfaden: Befehle, die der Agent nicht erraten kann, Stilregeln, die vom Üblichen abweichen, wie Tests laufen, Teametikette wie die Benennung von Branches, projektspezifische Entwurfsentscheidungen, Eigenheiten der Umgebung und nicht offensichtliche Stolpersteine. Was nicht hineingehört: alles, was der Agent aus dem Code selbst lesen kann, Standardregeln, die er schon kennt, lange Referenzdokumentation (verlinken Sie stattdessen), Dinge, die sich oft ändern, und Datei-für-Datei-Rundgänge durch das Projekt.
Wie lang. Zielen Sie auf unter etwa 200 Zeilen. Längere Dateien senken, wie gut die Anweisungen befolgt werden, weil wichtige Regeln im Rauschen untergehen. Regeln, die nur für einen Teil des Projekts gelten, können in pfadbezogene Regeln, die nur geladen werden, wenn der Agent an passenden Dateien arbeitet. Wissen, das nur manchmal gebraucht wird, kann in einen Skill, ein wiederverwendbares Anweisungspaket, das der Agent bei Bedarf lädt.
Wie formulieren. Machen Sie jede Zeile prüfbar. “Führe vor dem Commit npm test aus” lässt sich prüfen. “Schreibe gute Tests” nicht.
Wie lebendig halten. Behandeln Sie die Datei wie Code. In Git halten, bei Fehlverhalten prüfen und ausdünnen. Der Leitfaden gibt einen einfachen Test pro Zeile: Würde das Entfernen einen Fehler verursachen? Wenn nicht, löschen. Der Befehl /doctor kann Kürzungen vorschlagen, und ein Prompt-Audit sucht nach veralteten Anweisungen, Verweisen auf nicht mehr vorhandene Dateien und Zeilen, die sich widersprechen.
Es gibt außerdem Auto-Memory: Notizen, die Claude selbst aus Ihren Korrekturen schreibt. Sie werden zu Beginn jeder Sitzung geladen, bis zu einer dokumentierten Grenze von den ersten 200 Zeilen oder 25 KB. Lesen Sie sie ab und zu, denn sie kann eine falsche Lehre genauso enthalten wie eine richtige. Dieser letzte Punkt ist unser Rat, keine dokumentierte Regel.
Ein Grundgerüst zum Start, in unseren Worten:
# Befehle
- bauen, einen Test ausführen, Lint und Typprüfung: <genaue Befehle>

# Regeln, die vom Üblichen abweichen
- <eine Zeile pro Regel, jede prüfbar>

# Fertig heißt
- die Prüfung besteht und die Änderung entspricht dem genehmigten Plan
- die Abschlussnachricht zeigt den ausgeführten Befehl und seine Ausgabe

# Stolpersteine
- <was beim letzten Mal schiefging, in einer Zeile>

# Beim Verdichten behalten
- die Liste geänderter Dateien und die Testbefehle
10. Prüfung: Ein Test, der scheitern kann
Wenn wir nur eine Schicht behalten dürften, wäre es diese. Anthropic stellt sie an die erste Stelle: Geben Sie Claude eine Möglichkeit, seine Arbeit zu prüfen.
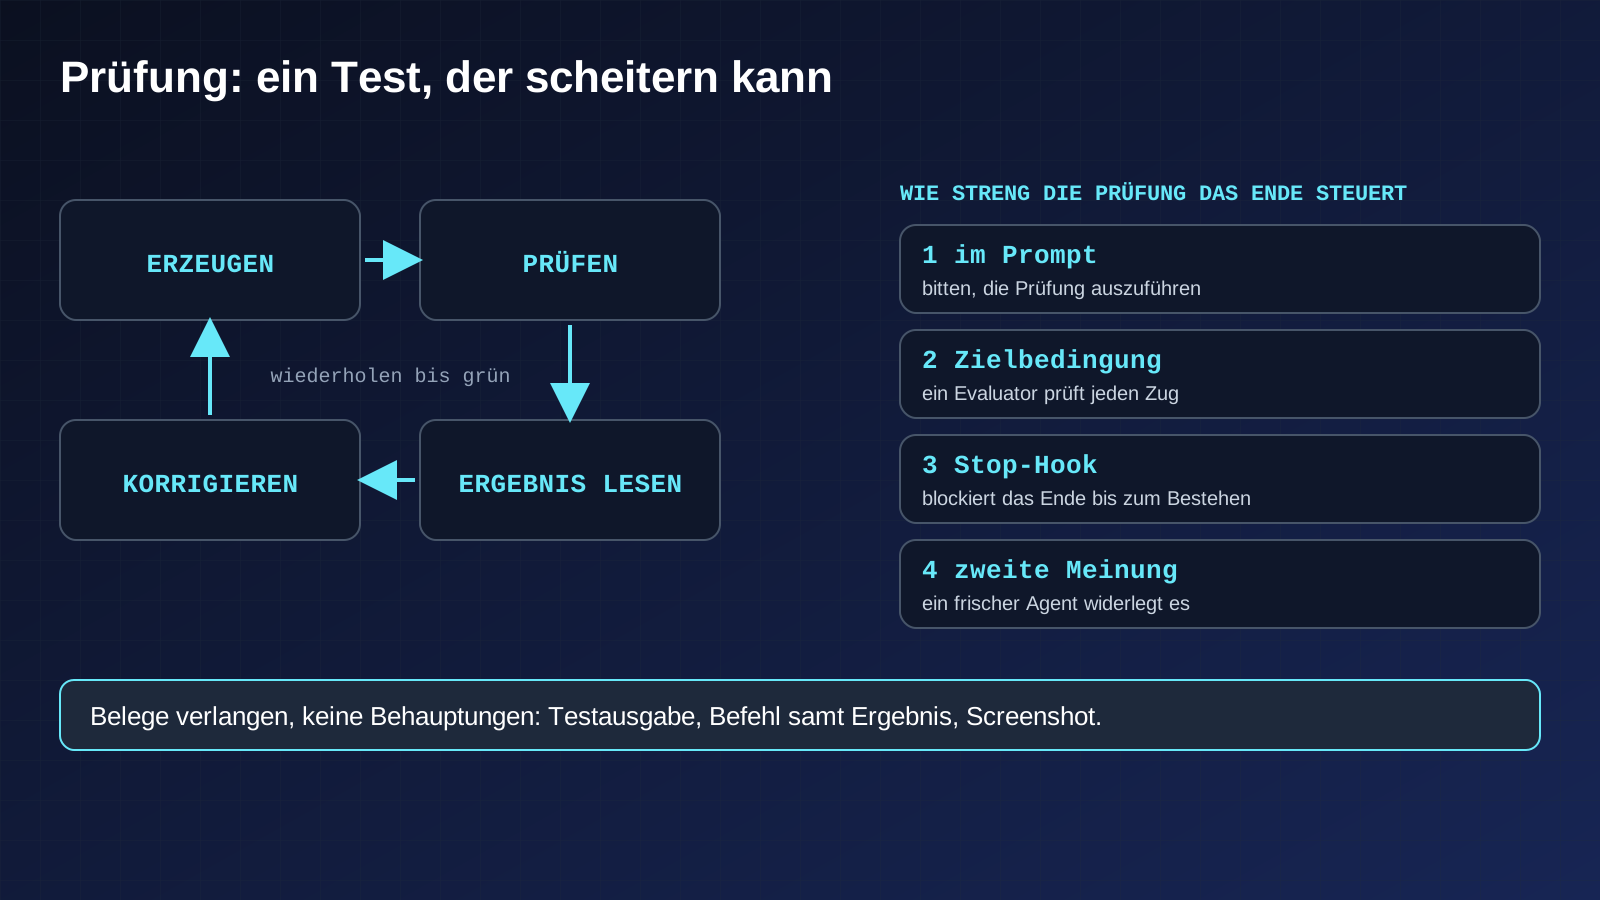
Die Logik ist einfach. Claude hört auf, wenn die Arbeit fertig aussieht. Hat es keinen Test, den es ausführen kann, ist “sieht fertig aus” das einzige Signal, und Sie werden zum Prüfer, der jeden Fehler selbst bemerken muss. Hat es eine Prüfung, die bestanden oder durchgefallen meldet, schließt sich die Schleife von selbst: Arbeit machen, Prüfung ausführen, Ergebnis lesen, nochmal versuchen.
Schreiben Sie die Prüfung vor der Arbeit. Das ist unsere Praxis. Eine nachträglich geschriebene Prüfung beschreibt tendenziell, was der Code schon tut, nicht was er tun soll.
Für das Passwort-Zurücksetzen sind gute Prüfungen ein automatisierter Test, der ein Zurücksetzen anfordert und bestätigt, dass eine E-Mail entsteht, ein Test, dass der Link nach einmaliger Nutzung nicht mehr funktioniert, und ein erfolgreicher Build des Projekts. Die Liste des Leitfadens: eine Testsuite, ein Build, der gelingen muss, ein Linter (ein Werkzeug, das Codeprobleme meldet), ein Skript, das die Ausgabe mit einem bekannten guten Beispiel vergleicht, oder ein Screenshot im Vergleich mit einem Entwurf.
Die schwache und die starke Fassung einer Bitte unterscheiden sich in einem Punkt:
| Schwach | Stärker |
|---|---|
| ”Mach das Dashboard schöner." | "Setze diesen Entwurf um, mache einen Screenshot des Ergebnisses, liste die Unterschiede auf und behebe sie." |
| "Der Build schlägt fehl." | "Der Build schlägt mit diesem Fehler fehl. Behebe die Ursache, verstecke den Fehler nicht, und bestätige, dass der Build durchläuft." |
| "Füge eine E-Mail-Validierung hinzu." | "Schreibe validateEmail mit diesen Beispielfällen, führe die Tests aus und zeige die Ausgabe.” |
Sehen Sie sich die mittlere Zeile an. “Ursachen beheben, nicht Symptome” steht aus gutem Grund im Leitfaden. Keine Fehlermeldung heißt nicht, dass der Code stimmt, und eine Prüfung, die nur nach Fehlern sucht, lässt sich erfüllen, indem man sie versteckt.
Wie streng die Prüfung das Ende steuert. Anthropic beschreibt vier Stufen:
- Im Prompt: Den Agenten bitten, die Prüfung auszuführen und weiterzumachen, bis sie besteht.
- Über eine Sitzung: Die Prüfung als
/goal-Bedingung setzen, und ein separater Evaluator prüft sie nach jedem Zug erneut. - Als hartes Tor: Ein
Stop-Hook führt Ihre Prüfung als Skript aus und verhindert das Ende des Zugs, bis sie besteht. - Durch eine zweite Meinung: Ein separater Agent versucht, das Ergebnis zu widerlegen, sodass nicht der Agent, der die Arbeit gemacht hat, sie auch bewertet.
Wählen Sie die niedrigste Stufe, bei der Sie noch weggehen können. Und verlangen Sie Belege, keine Behauptungen: die Testausgabe, den Befehl samt Ergebnis oder einen Screenshot. Der Leitfaden merkt an, dass Belege zu lesen schneller geht, als die Prüfung selbst zu wiederholen, und es funktioniert auch bei Sitzungen, die Sie nicht beobachtet haben.
Eine Zeile aus der Fehlerliste des Leitfadens lohnt die Wiederholung: Wenn Sie es nicht prüfen können, liefern Sie es nicht aus.
Eine Prüftabelle, die wir nutzen (unsere Praxis). Führen Sie für jede Anforderung im Plan eine Zeile in einer Datei, zum Beispiel checks.md:
| Schritt | Anforderung | Urteil | Beleg |
|---|---|---|---|
| 2 | Die Reset-Mail wird gesendet | bestanden | Testausgabe am angegebenen Pfad gespeichert |
| 3 | Der Link funktioniert nur einmal | gescheitert | zweite Nutzung wird noch akzeptiert, siehe Log |
| 4 | Der Build läuft durch | offen | noch nicht ausgeführt |
Das Urteil lautet bestanden, gescheitert oder offen. Fehlende Belege sichtbar lassen, statt sie aufzurunden. Das eigene Vertrauen des Modells kommt zuletzt, nach echten Signalen wie Tests, Builds, Typprüfungen, Screenshots und der tatsächlichen Ausgabe.
11. Subagenten: Helfer mit eigenem Schreibtisch
Ein Subagent ist ein Helfer, dem Claude eine Nebenaufgabe übergeben kann. Er hat ein eigenes Kontextfenster, eigene Anweisungen, eigenen Werkzeugzugriff und eigene Berechtigungen. Anthropics Beschreibung, wann man einen nutzt: Eine Nebenaufgabe würde Ihre Hauptunterhaltung mit Suchergebnissen, Logs oder Dateiinhalten fluten, die Sie nicht mehr brauchen. Der Subagent erledigt das an seinem eigenen Schreibtisch und gibt nur eine kurze Zusammenfassung zurück.
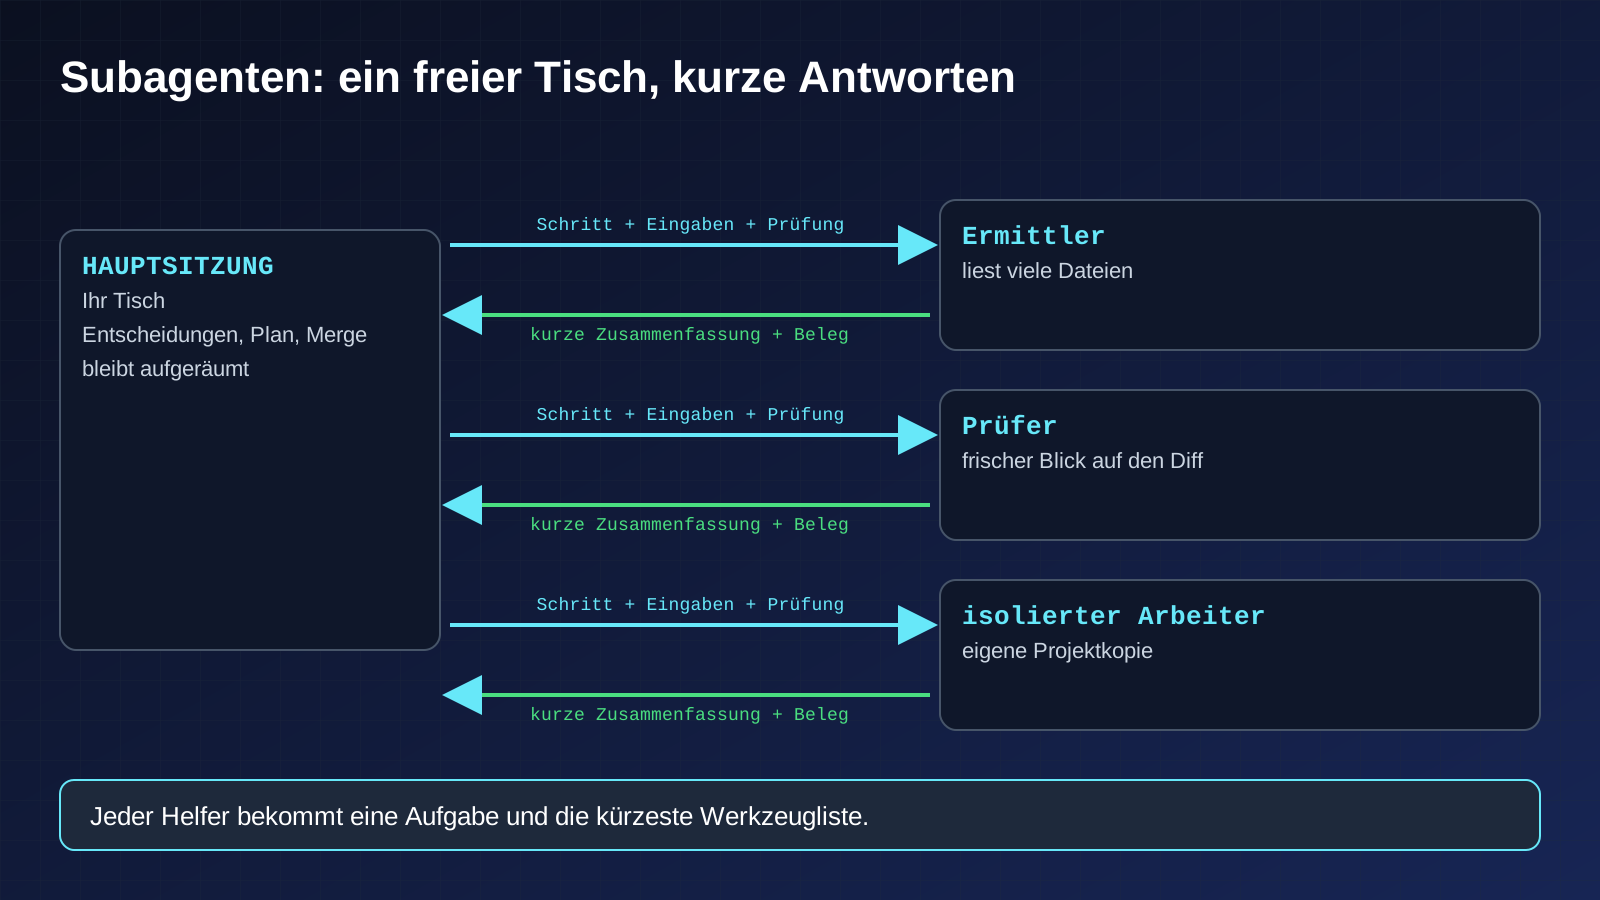
Der Hauptnutzen ist also, den eigenen Schreibtisch sauber zu halten, nicht Tempo. Wir nutzen drei Arten:
- Der Ermittler. Liest viele Dateien und bringt einen Absatz zurück. Für das Passwort-Zurücksetzen: “Finde heraus, wie wir derzeit E-Mails verschicken und ob es einen Helfer gibt, den wir wiederverwenden sollten.”
- Der Prüfer. Sieht die Änderungen und Ihre Kriterien mit frischem Blick, ohne die Überlegungen, die dazu geführt haben. Der Leitfaden nennt das einen adversarialen Review-Schritt. Er warnt, dass ein Prüfer, der Lücken finden soll, meist welche findet, auch wenn die Arbeit in Ordnung ist, und dass es zu Überengineering führt, allen nachzulaufen. Sagen Sie ihm, dass er nur Lücken melden soll, die Korrektheit oder die genannten Anforderungen betreffen.
- Der isolierte Arbeiter. Läuft in einem temporären Git-Worktree, einer getrennten Arbeitskopie des Projekts, sodass parallele Änderungen nicht kollidieren.
Einen Subagenten begrenzen Sie mit Feldern in einer Datei unter .claude/agents/, alle dokumentiert:
| Feld | Was es begrenzt |
|---|---|
tools, disallowedTools | Was er nutzen darf, sodass ein Prüfer lesen und suchen, aber nicht bearbeiten kann |
model | Auf welchem KI-Modell er läuft |
permissionMode | Wie er mit Berechtigungsabfragen umgeht |
maxTurns | Wie viele Schritte er machen darf, bevor er stoppt, mit als teilweise markierter Ausgabe |
isolation: worktree | Läuft in einer eigenen temporären Kopie, die bereinigt wird, wenn sich nichts geändert hat |
memory | Ob er sitzungsübergreifend Notizen behält |
skills | Anweisungspakete, die für ihn vorab geladen werden |
Unsere Regeln für ihren Einsatz:
- Eine enge Aufgabe pro Subagent, mit der kürzesten Werkzeugliste, die funktioniert.
- Den Auftrag wie eine Übergabenotiz schreiben. Er erhält seine eigenen Anweisungen und grundlegende Umgebungsangaben, nicht Ihre ganze Unterhaltung. Nennen Sie Ziel, Dateien, was nicht dazugehört und was ein Befund ist.
- Eine kurze, strukturierte Rückgabe verlangen: Zusammenfassung, Belege, offene Fragen.
- Die Nutzung im Blick behalten. Subagenten senden eigene Anfragen, die auf dieselben Nutzungslimits zählen wie Ihre Hauptunterhaltung.
12. Die Ausführungsschleife: Ausführen, prüfen, zurückgeben, wiederholen
Sobald Plan und Prüfungen existieren, ist ein Lauf eine Schleife. So sieht sie bei uns aus. Das ist unsere Praxis, gebaut aus den dokumentierten Bausteinen.
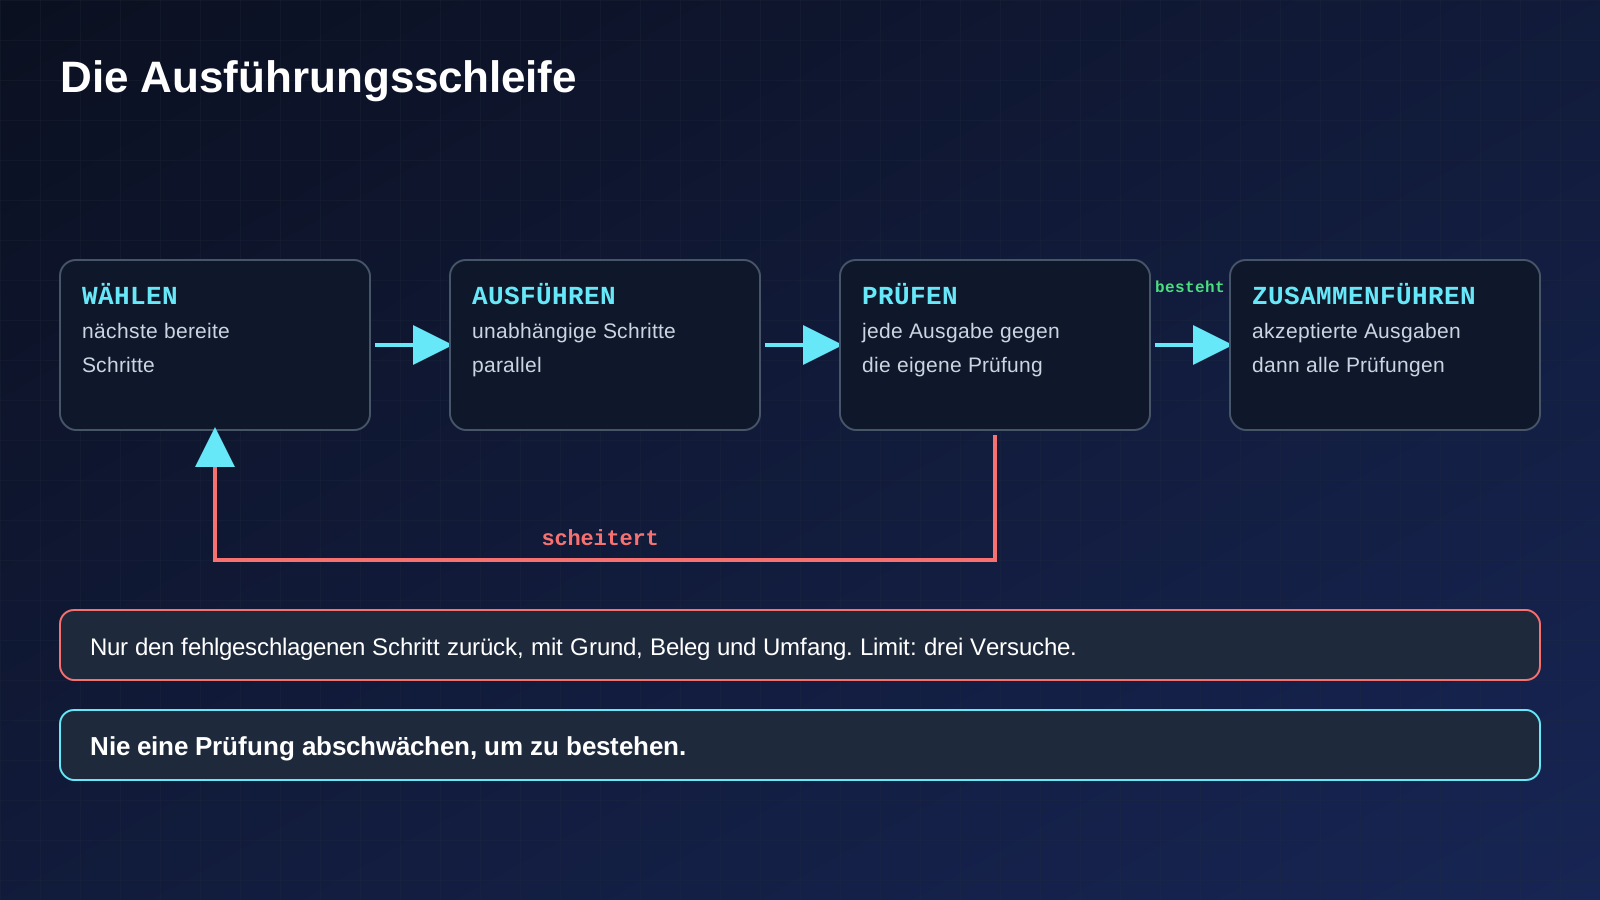
- Den Plan lesen und die nächsten bereiten Schritte wählen. Ein Schritt ist bereit, wenn die Schritte, von denen er abhängt, erledigt sind.
- Unabhängige Schritte parallel ausführen, jeden in einer eigenen Sitzung oder einem eigenen Subagenten.
- Jede Ausgabe gegen ihre eigene Prüfung verifizieren, sobald sie eintrifft.
- Fehlgeschlagene Schritte zurückgeben, nie den ganzen Stapel. Sind vier Teile gebaut und eines scheitert, schicken Sie nur dieses zurück, mit Grund, Beleg und einer Umfangszeile wie “nur diesen Schritt korrigieren”. Alles zurückzuschicken überschreibt korrekte Arbeit und macht aus einem Fehler vier unsichere Ergebnisse.
- Die akzeptierten Ausgaben zusammenführen und die vollständigen Prüfungen ausführen.
- Weitermachen, bis die Arbeit fertig ist, ein Hindernis auftaucht oder die Laufgrenze erreicht ist.
Zwei Regeln halten die Schleife ehrlich:
- Wiederholungen auf drei Versuche pro Schritt begrenzen. Scheitert ein Schritt nach drei Korrekturen, liegt das Problem wahrscheinlich im Plan, aus dem er stammt, und weitere Versuche sehen das nicht. Halten Sie an und gehen Sie zurück zum Plan.
- Nie eine Prüfung abschwächen, um zu bestehen. Ist eine Prüfung falsch, ändern Sie sie offen, als eigene Entscheidung, und schreiben Sie auf, warum.
Die dokumentierten Bausteine hinter dieser Schleife: Ein Stop-Hook hat eine eingebaute Obergrenze von acht aufeinanderfolgenden Blockaden, damit ein festhängender Agent nicht endlos kreist, und Anthropics eigene Fehlerliste warnt davor, in einer überladenen Sitzung immer wieder zu korrigieren.
13. Hochskalieren: Viele Agenten gleichzeitig
Wenn ein Agent gut arbeitet, sind die dokumentierten Wege, mehr gleichzeitig zu tun:
- Worktrees: mehrere Sitzungen, jede in einer eigenen Kopie des Projekts, damit Änderungen nicht kollidieren.
- Schreib- und Prüf-Sitzungen: Eine Sitzung baut, eine frische prüft. Eine frische Sitzung ist nicht voreingenommen gegenüber Code, den sie gerade selbst geschrieben hat. Derselbe Kniff funktioniert bei Tests: Eine Sitzung schreibt die Tests, eine andere schreibt Code, der sie besteht.
- Cloud- und Hintergrundsitzungen sowie Agententeams (experimentell und standardmäßig aus) für stärker automatisierte Koordination.
- Nicht-interaktive Läufe:
claude -p "prompt"führt Claude aus einem Skript aus, für automatisierte Prüfungen und Pipelines, und kann Klartext oder strukturiertes JSON zurückgeben. - Auffächern: der Befehl
/batch, der eine große Änderung auf 5 bis 30 Subagenten verteilt, jeder in einem eigenen Worktree, oder Ihre eigene Schleife überclaude -p-Aufrufe mit--allowedTools, um vorab freizugeben, was der Batch braucht.
Das Auffächer-Rezept des Leitfadens lohnt das Abschauen. Lassen Sie Claude die Aufgabenliste in eine Datei schreiben, schreiben Sie ein Skript, das die Liste durchläuft, testen Sie es an wenigen Einträgen, und führen Sie dann alles aus. Unsere Regel: klein anfangen und erst erweitern, wenn ein Lauf sauber ist.
14. Sitzungsgewohnheiten: Früh steuern, frei zurückspulen
- Korrigieren, sobald Sie Abdrift sehen.
Escstoppt den Agenten mitten in der Aktion und behält den Kontext. ZweimalEscoder/rewindöffnet Checkpoints, in denen Sie Gespräch, Code oder beides wiederherstellen können. “Mach das rückgängig” bittet ihn, zurückzusetzen. - Checkpoints sind nicht Git. Sie erfassen Änderungen über Claudes Dateiwerkzeuge, nicht Änderungen durch Shell-Befehle oder andere Programme.
- Nach zwei gescheiterten Korrekturen leeren und neu starten. Die Begründung des Leitfadens: Der Kontext ist nun voller gescheiterter Versuche, und eine saubere Sitzung mit schärferem Prompt schlägt meist eine lange mit angehäuften Korrekturen.
- Sitzungen benennen und fortsetzen mit
claude --continueoder--resume, sodass jede Arbeit ihren eigenen Kontext behält. - Urteilsvermögen nutzen. Der Leitfaden selbst sagt, Sie sollen Ihre Intuition entwickeln: Manchmal ist der Verlauf wertvoll, manchmal ist ein vager Prompt richtig, manchmal ist Planen nur Aufwand.
15. Feedback: Entscheiden, wo die Regel lebt
Jedes Harness scheitert auf dieselben wenigen Arten. Nach einem Fehler lautet die nützliche Frage nicht “Was sage ich als Nächstes?”, sondern “Wo soll diese Regel leben?” Unsere Leiter, von schwach nach stark:
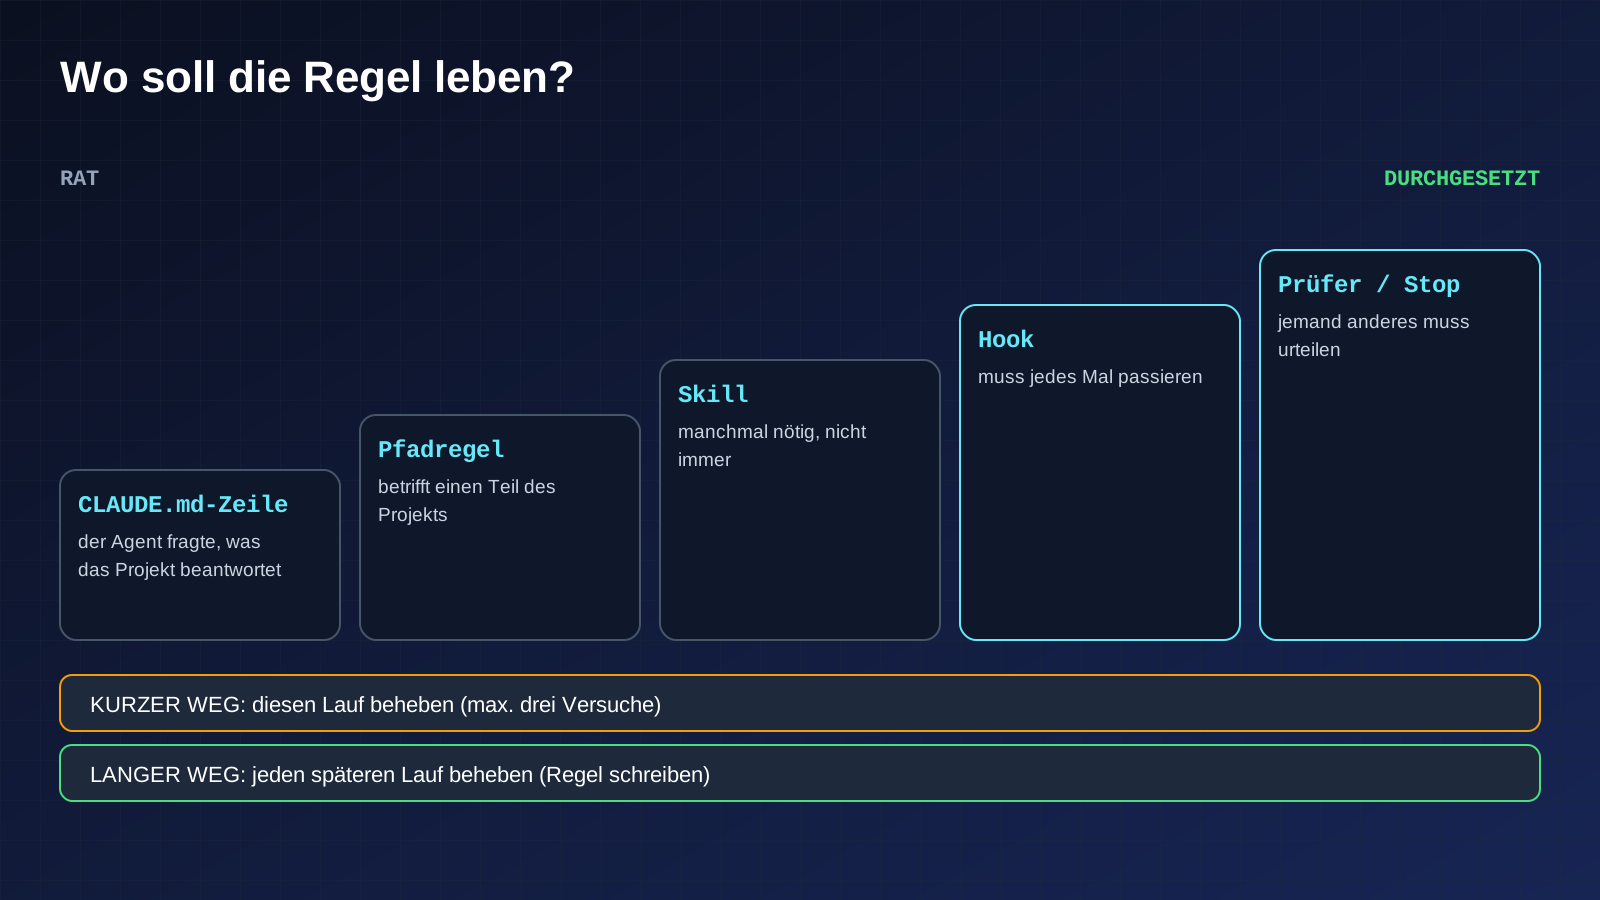
| Was schiefging | Wohin die Lösung gehört |
|---|---|
| Der Agent fragte etwas, was das Projekt schon beantwortet | Eine prüfbare Zeile in CLAUDE.md |
| Eine Regel betrifft nur einen Teil des Projekts | Eine pfadbezogene Regel, die nur dort geladen wird |
| Wissen wird manchmal gebraucht, nicht immer | Ein Skill, bei Bedarf geladen |
| Es muss jedes Mal passieren | Ein Hook |
| Jemand anderes als der Autor muss urteilen | Ein Prüfer-Subagent oder eine Stop-Prüfung |
Dann die Schleife:
- Den Agenten korrigieren.
- Taucht derselbe Fehler zweimal auf, die Regel auf der passenden Sprosse der Leiter schreiben.
- Die Sitzung leeren und mit dem besseren Prompt neu versuchen, damit Sie die Regel testen und nicht den Verlauf.
- Ab und zu ausdünnen: Regeln löschen, die das Modell inzwischen ohne Aufforderung befolgt, Widersprüche beheben und Auto-Memory auf falsche Lehren lesen.
Die zwei Rückwege. Ein Harness braucht zwei Wege, auf denen Lehren zurückfließen, und die meisten bauen nur den ersten.
- Der kurze Weg behebt diesen Lauf. Scheitert eine Prüfung, geht der Schritt mit Grund, Beleg und Umfang (“nur diesen Schritt korrigieren”) zurück, begrenzt auf drei Versuche, wie in der Schleife oben.
- Der lange Weg behebt jeden späteren Lauf. Bemerken Sie einen Fehler oder landet eine Korrektur, schreiben Sie die Regel in CLAUDE.md, eine pfadbezogene Regel, einen Skill oder einen Hook, anhand der Leiter oben, damit die nächste Sitzung ihn nie wiederholt. Ein System, das schnell ist, aber nie klüger wird, hat nur den kurzen Weg.
16. Abschluss: Die Ziellinie prüfen
Eine Aufgabe ist nicht fertig, wenn der Agent es sagt. Vor der letzten Nachricht schreiben wir eine Abschluss-Checkliste, die aus den Abnahmeprüfungen entsteht. Jeder Punkt muss auf beobachtbare Belege zeigen.
- Jedes Ergebnis existiert und lässt sich öffnen.
- Jede Prüfung lief gegen die gespeicherte Version, nicht gegen eine frühere.
- Fehlschläge sind entweder behoben oder ausdrücklich gemeldet.
- Die Briefing-Datei enthält jede neue Regel, die im Lauf gelernt wurde.
Stoppt eine Grenze oder ein Hindernis den Lauf, ist das richtige Ergebnis ein Teilstatus mit den genauen verbleibenden Schritten, nicht eine selbstsichere Zusammenfassung, die die Lücke verbirgt.
17. Übergabe: Eine saubere Spur hinterlassen
Lange Arbeit überdauert Sitzungen, und die nächste Sitzung beginnt mit leerem Tisch. Wir führen eine kurze Fortschrittsdatei (zum Beispiel progress.md) und aktualisieren sie nach jeder Phase. Sie enthält:
- Plan: erledigte, laufende und blockierte Schritte.
- Ergebnisse: die genauen Pfade zu den aktuell gespeicherten Dateien.
- Entscheidungen: was sich am Harness geändert hat und warum.
- Offene Punkte: Fehlschläge, Unsicherheiten und Hindernisse.
- Nächste Aktion: der nächste bereite Schritt.
Beim Fortsetzen liest die neue Sitzung zuerst die Briefing-Datei, den Plan und die Fortschrittsdatei und macht dann beim notierten nächsten Schritt weiter. Das sind dieselben Dinge, die auch eine Kontext-Zusammenfassung behalten sollte.
18. Lieferung: Was Sie zurückgeben
Der dokumentierte letzte Schritt ist eine klare Commit-Nachricht und ein Pull Request, was gut klappt, wenn gh installiert ist. Darüber hinaus übergeben wir ein kleines, einheitliches Paket:
- Das Ergebnis selbst.
- Den Plan, die Prüftabelle und die Fortschrittsdatei.
- Den Diff der Briefing-Datei, damit Sie sehen, welche Regeln ergänzt wurden.
- Eine klare Aussage dazu, was geprüft wurde, was bestanden hat und was offen bleibt.
- Nutzungszahlen nur, wenn sie tatsächlich vorliegen. Schätzen Sie keine Einsparungen, die Sie nicht gemessen haben.
Speichern Sie das funktionierende Harness nach der Prüfung als wiederverwendbare Vorlage, damit die nächste Aufgabe mit einem getesteten Setup beginnt. Und passen Sie die menschliche Aufmerksamkeit an die Kosten des Rückgängigmachens an: Kleine, leicht umkehrbare Arbeit kann durch eine automatische Prüfung laufen, Änderungen an gemeinsamem Code bekommen Prüfungen plus Review, und alles, was schwer umkehrbar ist, etwa Datenbankmigrationen, Löschungen oder echte Kundendaten, bleibt eine menschliche Entscheidung.
Fehlermuster aus Anthropics eigener Liste
| Muster | Was es bedeutet | Lösung |
|---|---|---|
| Die Alles-durcheinander-Sitzung | Unabhängige Themen stapeln sich in einem Gespräch | /clear zwischen Aufgaben |
| Immer wieder korrigieren | Gescheiterte Versuche verstopfen den Kontext | Nach zwei gescheiterten Korrekturen leeren und einen besseren Prompt schreiben |
| Die überladene CLAUDE.md | So viele Regeln, dass die wichtigen untergehen | Ausdünnen oder Regeln in Hooks verwandeln |
| Die Vertrauen-dann-prüfen-Lücke | Plausibler Code, der Sonderfälle übersieht | Immer eine Prüfung geben; wenn Sie es nicht prüfen können, nicht ausliefern |
| Die endlose Erkundung | Ein unbegrenztes “untersuche” füllt den Kontext | Die Frage eingrenzen oder einen Subagenten nutzen |
Glossar
- Agent: eine KI, die Aktionen auf ein Ziel hin ausführt, nicht nur antwortet.
- Harness: das Gerüst um einen Agenten: Anweisungen, Grenzen, Prüfungen und Feedback.
- Kontextfenster: alles, was der Agent während einer Sitzung im Kopf hält.
- Plan-Modus: ein Modus, in dem der Agent lesen, aber nichts ändern kann.
- CLAUDE.md: die Briefing-Datei, die der Agent zu Beginn jeder Unterhaltung liest.
- Hook: ein Skript, das zu einem festen Zeitpunkt automatisch läuft und eine Aktion blockieren kann.
- Subagent: ein Helfer mit eigenem Kontext, eigenen Werkzeugen und Berechtigungen.
- Worktree: eine getrennte Arbeitskopie eines Projekts, damit parallele Änderungen nicht kollidieren.
- MCP: ein Standard, um externe Werkzeuge an einen KI-Agenten anzuschließen.
- Sandbox: ein isolierter Bereich, der begrenzt, was der Agent erreichen kann.
- Pull Request: ein Vorschlag, Änderungen in ein Projekt zu übernehmen, zur Prüfung.
Die Regel zum Übernehmen
Lassen Sie nie einen Agenten selbst entscheiden, dass seine Arbeit fertig ist. Definieren Sie “fertig” als Prüfung, die er ausführen kann, setzen Sie Regeln, die gelten müssen, im Code durch, und lassen Sie ihn Ihnen den Beleg zeigen.
Wo Incresco ins Spiel kommt
Incresco ist Claude-Partner. Dieses Setup nutzen wir, wenn wir selbst KI-Agenten bauen. Wenn Sie dieselbe Disziplin in den Agenten wollen, auf die sich Ihr Unternehmen verlässt, sprechen Sie Incresco an und fragen Sie nach einem Plan für die KI-Transformation, der mit einem Ablauf beginnt.
Quellen: Anthropic, Claude-Code-Dokumentation: Best practices, Memory und CLAUDE.md, Hooks guide, Hooks reference, Subagents, Permission modes, Checkpointing, Commands (mit /batch), Goal, Agent teams, Run Claude Code programmatically. Befehle, Standardwerte und Tarifverfügbarkeit ändern sich zwischen Versionen, prüfen Sie daher die Dokumentation zu Ihrer Version.
Ähnliche Artikel
Business
Agentforce Memory: Was Salesforce- und WhatsApp-KI-Agenten behalten sollten
Salesforce erklärt die Entwicklung von Agentforce Memory. Was sollten KI-Agenten in Web, App und WhatsApp behalten, neu prüfen oder vergessen?
Insight lesen
Engineering
Agentforce Voice für Agent Script: Was Sie prüfen sollten, bevor Ihr Salesforce-Agent spricht
Salesforce sagt, Sprache lasse sich ohne Neuentwicklung zu einem Agent-Script-Agenten hinzufügen. Was Ihre Org braucht und wie Sie Anweisungen für das Ohr schreiben.
Insight lesen